1. Почему ИИ нужны корпоративные знания
Языковая модель может анализировать информацию и отвечать на вопросы, но сама по себе не знает внутренних регламентов компании, актуальных инструкций и корпоративных документов.
Чтобы ИИ мог использовать эти знания в работе, применяют подход RAG (Retrieval-Augmented Generation). В статье разбираем, как работает RAG, какие задачи решает Knowledge Engine от Gorgona и что важно учесть при создании корпоративной базы знаний: от загрузки документов и настройки прав доступа до проверки качества поиска и ответов.
Языковые модели умеют работать с текстом, анализировать информацию и отвечать на вопросы. Но у любой модели есть ограничение: она не знает, что происходит внутри конкретной компании прямо сейчас, какие решения приняты руководством, где хранится актуальная документация и какие правила действуют во внутренних процессах.
Можно попросить ИИ подготовить ответ на вопрос клиента, найти инструкцию для сотрудника или объяснить внутренний регламент. Но если нужной информации нет в контексте модели, она не сможет надежно ответить на основе документов компании.
Теоретически можно дообучить модель на корпоративных данных или передавать ей большой массив документов целиком. На практике оба подхода имеют ограничения: дообучение требует дополнительных ресурсов и не всегда подходит для работы с меняющейся информацией, а передача всего массива документов в запросе может быть дорогой и неэффективной.
Поэтому для работы с внутренними знаниями используют другой подход — RAG (Retrieval-Augmented Generation). В Gorgona для работы с корпоративными знаниями и управления доступом к ним предусмотрен отдельный модуль Knowledge Engine.
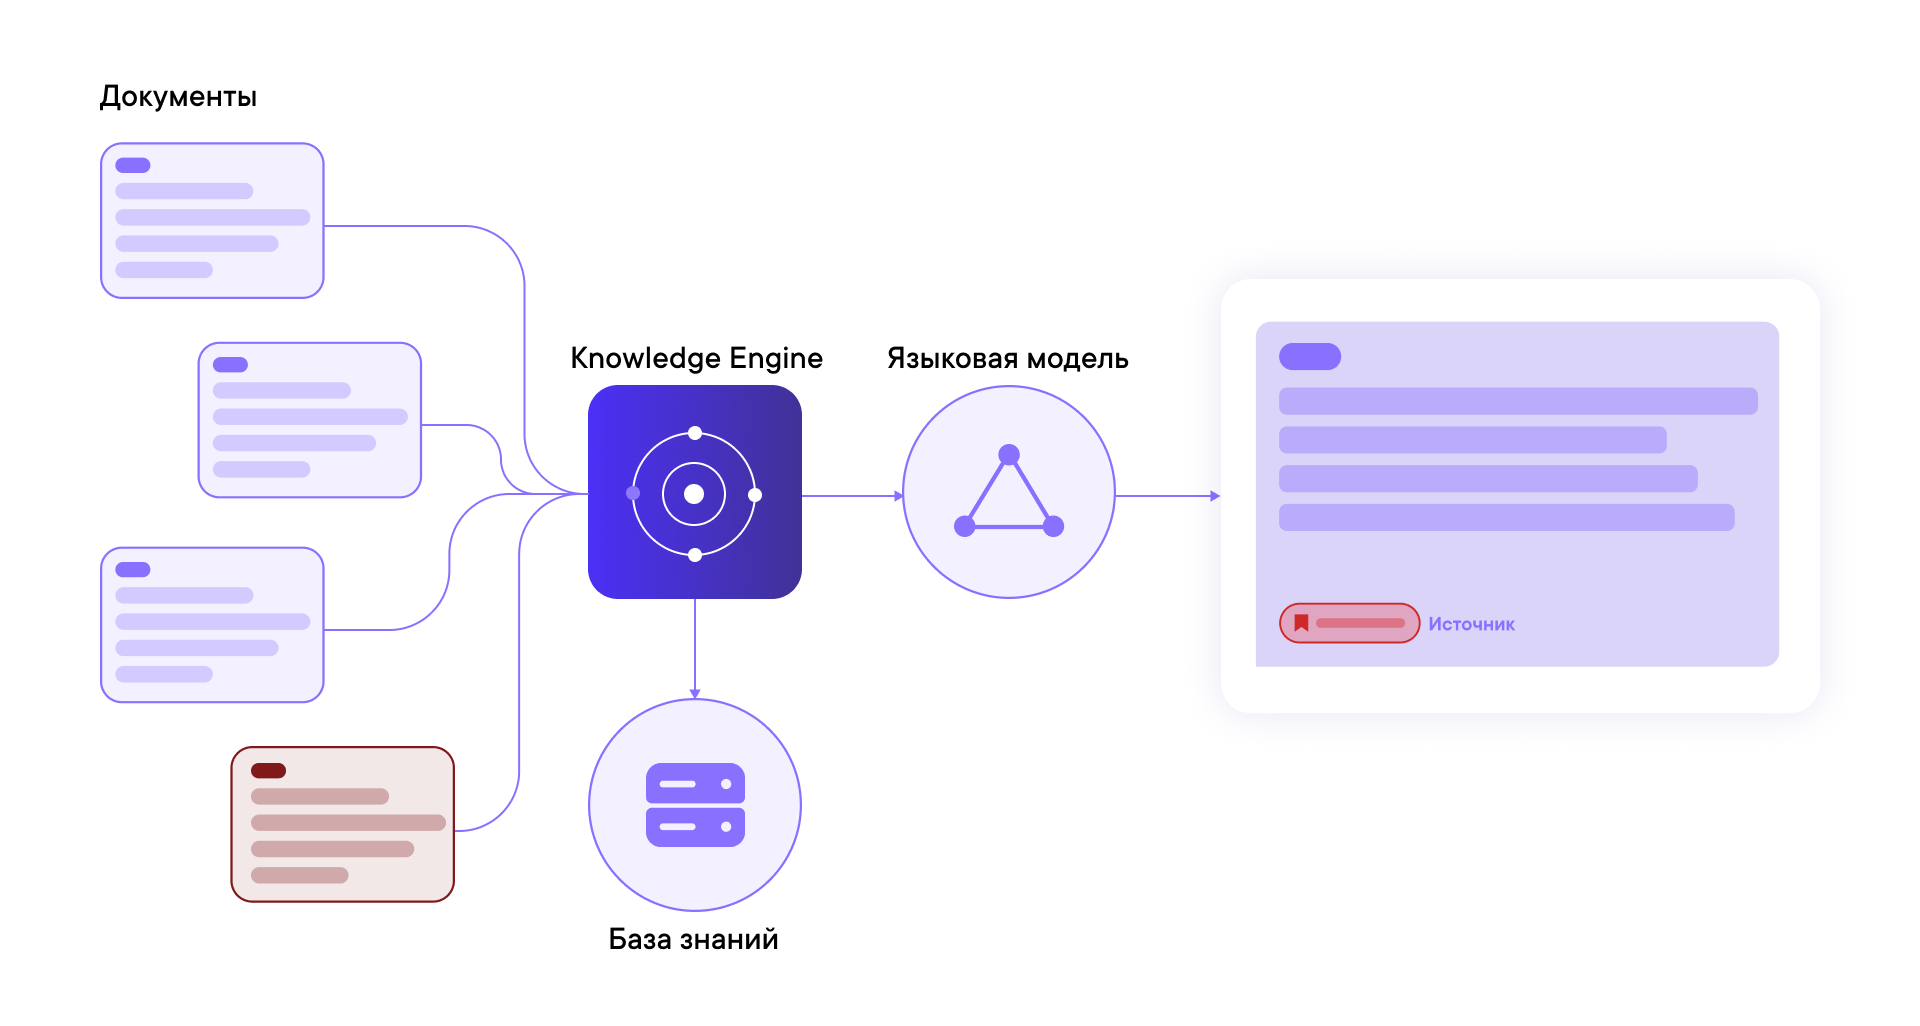
Knowledge Engine помогает организовать доступ ИИ к корпоративным документам: находить информацию по смыслу, передавать подходящие фрагменты модели и учитывать права пользователя, который задает вопрос.
Модуль можно использовать в разных сценариях:
- Поддержка клиентов. Операторы и чат-боты получают ответы на основе регламентов о возвратах, доставке, гарантиях и других процессах.
- Внутренний helpdesk. Сотрудники могут находить ответы в политиках HR, информационной безопасности и ИТ.
- Юридические и нормативные документы. Поиск помогает работать с договорами, внутренними регламентами и нормативными материалами.
- База знаний для внешнего агента. Knowledge Engine предоставляет доступ к корпоративным знаниям уже существующему ИИ-агенту заказчика.
2. Что такое RAG и как он работает
RAG — это подход, при котором перед формированием ответа система находит в базе знаний информацию, релевантную запросу пользователя, и передает ее языковой модели в качестве дополнительного контекста.
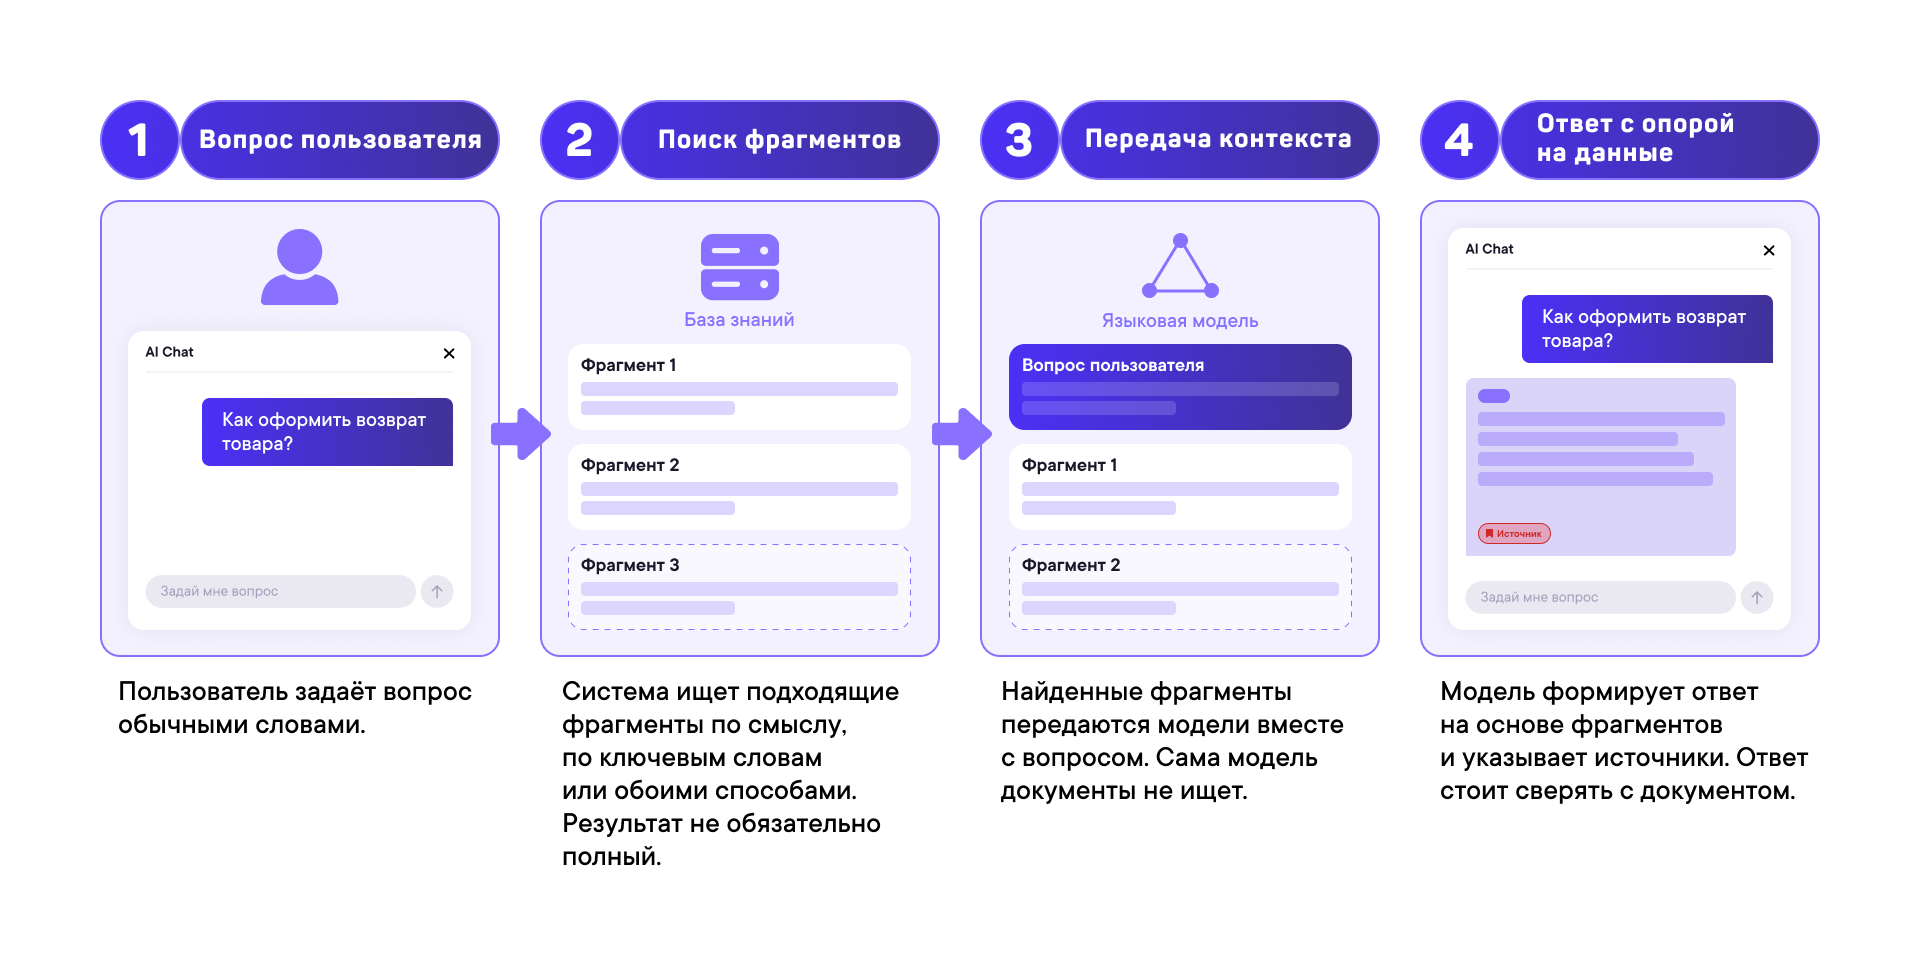
Представим, что сотрудник спрашивает: «Как оформить возврат товара?»
В документах компании нужный процесс может быть описан иначе: например, «Порядок обработки обращений по возврату продукции». Обычный поиск по точному совпадению слов может не найти подходящий фрагмент. Семантический поиск позволяет сопоставить запрос с документом по смыслу.
Чтобы это работало, документы предварительно обрабатываются.
- Подготовка документов. Текст извлекается из загруженных файлов или подключенных источников.
- Разбиение на фрагменты. Большой документ делится на небольшие части — чанки. Это позволяет искать отдельные смысловые фрагменты, а не передавать модели весь документ целиком.
- Индексация. Система подготавливает фрагменты к поиску и сохраняет необходимые для этого данные.
- Поиск по запросу. Когда пользователь задает вопрос, система ищет наиболее релевантные фрагменты.
- Формирование ответа. Найденные фрагменты передаются языковой модели вместе с исходным вопросом. Модель использует этот контекст для подготовки ответа.
Например, вместо того чтобы самостоятельно вспоминать правила возврата, ИИ получает подходящие фрагменты внутренней инструкции и формирует ответ на их основе.
В Knowledge Engine доступны три режима поиска: по смыслу, по ключевым словам и гибридный. По умолчанию используется гибридный поиск, который сочетает смысловое сопоставление с поиском по ключевым словам. Дополнительно можно включить переранжирование результатов: оно помогает повысить точность отбора релевантных фрагментов, хотя ответ может формироваться немного медленнее.
RAG не гарантирует, что ответ всегда будет правильным. Результат зависит от качества исходных документов, поиска, настроек обработки и самой модели. Поэтому базу знаний важно не только наполнить, но и регулярно проверять.
3. Что делает Knowledge Engine
RAG — это подход к поиску и использованию информации. Knowledge Engine — модуль Gorgona, который помогает организовать этот процесс в корпоративной среде.
Он решает не только задачу поиска по документам. Для бизнеса важно понимать, откуда берутся данные, кто может их использовать, насколько хорошо система находит нужную информацию и как поддерживать базу знаний в актуальном состоянии.
В Knowledge Engine предусмотрены инструменты для работы с базами знаний, обработки документов, поиска по их содержимому и разграничения доступа. В более широком контуре работы с корпоративными знаниями также важны контроль качества, отслеживание запросов и процессы сопровождения базы.
Knowledge Engine можно использовать вместе с другими модулями Gorgona или подключать к отдельному сценарию в зависимости от задачи заказчика. Например, у компании уже может быть собственный ИИ-агент, которому не хватает доступа к корпоративной информации.
Подключить внешнего агента можно двумя способами: через LLM Box — по OpenAI-совместимому API с ключом доступа — или через Agent API, который позволяет вызывать агента Gorgona. В обоих случаях поиск по базе знаний и проверка прав выполняются на стороне платформы: внешнему агенту не нужно реализовывать эти механизмы самостоятельно.
4. Как документы попадают в базу знаний
Корпоративная информация редко хранится в одном месте. Документы могут находиться в сетевых папках, системах управления знаниями и других внутренних сервисах. Поэтому один из практических вопросов при внедрении Knowledge Engine — как организовать поступление данных из уже используемых компанией источников.
Есть два способа добавить документы в базу знаний:
- Загрузить вручную через интерфейс — в виде файлов или текста.
- Подключить корпоративные системы с помощью коннекторов. Сейчас доступны готовые коннекторы к Confluence и Jira. Подключение других источников запланировано.
Knowledge Engine поддерживает файлы PDF, DOCX, HTML и Markdown, а также текст, который пользователь вставляет вручную. Максимальный размер загружаемого файла — 50 МБ.
Данные из корпоративных систем обновляются через синхронизацию коннекторов. Если документ добавили вручную, для обновления его нужно загрузить повторно.
Структура базы знаний организована по схеме «база знаний → папки». Документы можно распределять по папкам в соответствии с задачами компании: например, по подразделениям, типам документов или рабочим процессам. Папки также используются для настройки прав доступа.
После загрузки документы проходят обработку: система извлекает текст, разбивает его на фрагменты и подготавливает к поиску. Встроенный OCR позволяет загружать сканы напрямую: при обработке система распознает текст, таблицы и формулы. При этом физическое сканирование бумажных документов остается на стороне заказчика.
5. Как ИИ находит нужные сведения
После подготовки документов пользователь может задать вопрос в чате или обратиться к агенту, который использует Knowledge Engine.
Модель получает исходный запрос и информацию о доступных ей инструментах. Если ей нужны дополнительные сведения и настроенная интеграция поддерживает вызов инструментов, модель обращается к базе знаний.
Knowledge Engine выполняет поиск и возвращает несколько наиболее релевантных фрагментов вместе с информацией об исходных документах. Количество фрагментов задается в настройках базы знаний. Если контекста не хватает, модель может сделать несколько запросов к базе в пределах установленных ограничений.
Модель использует полученную информацию для ответа. Таким образом, она не получает всю корпоративную документацию целиком, а обращается к фрагментам, которые система считает релевантными конкретному запросу.
Такой сценарий зависит от возможностей используемой модели и настроенной интеграции: не каждая модель поддерживает вызов инструментов одинаковым образом.
6. Контроль доступа: какие данные может использовать конкретный сотрудник
Для корпоративного использования недостаточно просто дать ИИ доступ ко всем документам. Разные сотрудники имеют разные полномочия, и система должна учитывать это при поиске информации.
Представим компанию, в которой есть генеральный директор, бухгалтерия и служба технической поддержки. Руководителю может требоваться широкий доступ к корпоративной информации, тогда как специалисту поддержки нужны только инструкции и документы, относящиеся к его работе.
Если все документы доступны без разграничения прав, появляется риск, что сотрудник получит информацию, которую ему не следует видеть.
В Knowledge Engine доступ к элементам базы знаний разграничивается по командам. Права настраиваются для папок, поэтому можно организовать доступ к документам с учетом того, каким командам они предназначены.
Важно, чтобы ограничения учитывались на этапе поиска. Система должна искать информацию только в той области знаний, к которой у пользователя есть доступ, а не сначала извлекать любые фрагменты, а потом пытаться скрыть запрещенные результаты.
Это необходимо, чтобы недоступные сотруднику сведения не попадали в контекст, передаваемый языковой модели.
Таким образом, Knowledge Engine помогает организовать управляемый доступ к корпоративным данным, учитывая разрешения для конкретных команд.
7. Не только поиск: контроль и сопровождение корпоративных знаний
База знаний не заканчивается на этапе загрузки документов. Информация меняется, появляются новые инструкции, старые документы теряют актуальность, а результаты поиска могут оказаться нерелевантными. Поэтому важно определить, кто будет следить за состоянием базы знаний и поддерживать ее в рабочем состоянии.
Для этого мы рекомендуем заказчику выделить роль Data Steward. Этот сотрудник отвечает за актуальность базы: обновляет документы, следит за правами доступа и качеством поиска. Это организационная роль на стороне заказчика, а не отдельная роль, которую необходимо назначать в интерфейсе Knowledge Engine.
В самом продукте предусмотрены инструменты управления документами:
- статусы обработки для каждого документа;
- возможность заменять и удалять документы;
- переиндексация при изменении настроек обработки. Во время переиндексации поиск продолжает работать.
Эти инструменты помогают сопровождать базу знаний по мере изменения документов и требований к поиску.
8. Как оценивать качество поиска и ответов
Даже если документы загружены правильно, это не означает, что система будет находить нужные фрагменты в каждом случае.
На качество влияют несколько факторов: как документ разбит на фрагменты, насколько хорошо исходный текст структурирован и подходит ли выбранный способ поиска для конкретного типа информации.
Например, в длинных юридических документах могут быть сложные перекрестные ссылки и зависимости между разделами. Если разбить такой документ на небольшие независимые фрагменты, часть контекста может потеряться. Для разных типов документов можно выбирать способ и размер нарезки на фрагменты; изменение этих настроек не останавливает поиск.
Один из подходов к оценке качества — Golden Dataset, методика, с которой мы работаем при внедрении. Вместе с заказчиком готовится набор контрольных вопросов и эталонных ответов.
Работа с таким набором может выглядеть следующим образом:
- Вместе с заказчиком формируют список вопросов, которые действительно важны для его процессов.
- Для каждого вопроса подготавливают эталонный ответ или критерии оценки.
- Запускают тестирование на текущей конфигурации базы знаний.
- Сравнивают ответы системы с эталонами с помощью оценочной модели.
- Анализируют результаты и меняют настройки обработки документов, поиска или другие параметры.
- Повторяют проверку, чтобы понять, улучшилось ли качество.
Такая оценка помогает сравнивать конфигурации и находить проблемные места. Но полученная метрика не является универсальным показателем точности ИИ: ее значение зависит от выбранных вопросов, эталонов и метода сравнения.
Дополнительно качество поиска можно проверить вручную в Search playground — тестовом поиске. В нем видно, какие фрагменты находит система и из каких документов они получены. Это помогает понять, почему конкретный запрос возвращает определенные результаты, и оценить, насколько хорошо поиск работает с нужными материалами.
Автоматические тесты и ручная проверка не отменяют проверки на реальных рабочих сценариях вместе с пользователями.
9. Наблюдаемость: как понять, откуда взялся ответ
Когда ИИ использует корпоративные знания, важно понимать не только итоговый ответ, но и путь, по которому система к нему пришла.
Для администратора в трейcах платформы Gorgona можно увидеть, какой вопрос задал пользователь, как модель обратилась к базе знаний и какие фрагменты получила. Это помогает разобраться в ситуации, когда ответ оказался неожиданным, и выяснить, какие сведения система использовала при его подготовке.
Пользователь также может увидеть источники ответа в чате: под ответом отображаются база знаний и документ, из которого была взята информация.
Трейсы относятся к общей функциональности платформы Gorgona; подробнее о наблюдаемости будет рассказано в отдельном материале.
10. Как внедрять Knowledge Engine
Внедрение корпоративной базы знаний начинается не с загрузки всех файлов подряд, а с понимания того, какие сведения нужны ИИ и кто должен иметь к ним доступ.
Шаг 1. Определить задачи и источники данных. Нужно понять, на какие вопросы должен отвечать ИИ, где хранится нужная информация и как часто она меняется.
Шаг 2. Организовать структуру знаний. Документы распределяют по базам знаний и папкам — например, по подразделениям, типам документов или рабочим процессам. Это помогает разделять наборы информации и настраивать доступ к ним.
Шаг 3. Настроить получение данных. Выбирают способ загрузки: вручную или через коннекторы к корпоративным системам. Для других источников, помимо доступных готовых коннекторов, может потребоваться дождаться реализации или отдельно согласовать вариант интеграции.
Шаг 4. Подготовить документы к поиску. Выбирают параметры обработки текста, способ и размер разбиения на фрагменты, а также режим поиска. Настройки могут отличаться для разных типов документов.
Шаг 5. Настроить доступ. Определяют, какие команды могут обращаться к конкретным базам знаний и папкам.
Шаг 6. Проверить качество. Создают контрольный набор вопросов, тестируют поиск и ответы, анализируют ошибки и корректируют конфигурацию. Для ручной проверки можно использовать Search playground.
Шаг 7. Провести проверку с пользователями. Нужно убедиться, что система решает реальные рабочие задачи, корректно обрабатывает типичные запросы и не предоставляет лишнюю информацию.
Шаг 8. Организовать сопровождение. Определяют, кто отвечает за обновление документов, контроль прав и качества поиска. Для этого заказчику рекомендуется выделить Data Steward. Если информация меняется в исходных системах, необходимо также организовать синхронизацию коннекторов; документы, загруженные вручную, обновляются повторной загрузкой.
При работе с бумажными архивами заказчику сначала нужно отсканировать документы. После этого сканы можно загружать в Knowledge Engine напрямую: встроенный OCR распознает текст, таблицы и формулы при обработке.
11. Где заканчивается RAG и начинается Knowledge Engine
Эти понятия важно не смешивать.
RAG — подход, позволяющий находить релевантную информацию и передавать ее языковой модели для формирования ответа.
Knowledge Engine — модуль Gorgona, который организует работу с корпоративными знаниями и добавляет к процессу поиска возможности управления доступом и сопровождения базы.
Gorgona — платформа, в которой доступны разные инструменты для работы с ИИ. Knowledge Engine может использоваться вместе с другими модулями или подключаться к конкретному сценарию в зависимости от задачи заказчика.
В рамках общей продуктовой логики другие модули отвечают за свои участки процесса. LLM Box предназначен для управления подключением и использованием языковых моделей, а Guardrails — для применения правил к запросам и ответам модели. Knowledge Engine работает с корпоративной информацией и определяет, какие знания могут быть доступны в конкретном сценарии.
Эти задачи связаны между собой, но не взаимозаменяемы. Например, право сотрудника получить данные из внутренней базы и проверка того, какие данные передаются внешней модели, — разные вопросы, для которых нужны разные механизмы контроля.
12. Что получает бизнес
Для компании Knowledge Engine — это способ организовать работу ИИ с внутренней информацией, которая не содержится в общих знаниях языковой модели.
Вместо того чтобы вручную искать инструкции в разных хранилищах или самостоятельно разрабатывать всю инфраструктуру поиска, компания может выстроить процесс, в котором ИИ получает релевантные фрагменты корпоративных документов.
При этом важны не только скорость получения информации, но и управляемость процесса:
- сотрудники получают доступ к тем данным, которые разрешены их командам;
- ИИ может использовать внутренние документы при подготовке ответов;
- качество поиска можно проверять на контрольных вопросах и вручную в тестовом поиске;
- работу с базой знаний можно сопровождать и улучшать;
- администраторы могут анализировать обращение модели к базе знаний с помощью трейсов платформы, а пользователи — видеть источники ответа в чате.
При этом Knowledge Engine не отменяет необходимость поддерживать документы в актуальном состоянии, проверять результаты и правильно организовывать права доступа. Он создает инфраструктуру для работы с корпоративными знаниями, но качество результата по-прежнему зависит от данных, настроек и конкретного сценария использования.
Главная идея Knowledge Engine — предоставить ИИ управляемый доступ к знаниям компании, чтобы он мог отвечать на рабочие вопросы с опорой на внутреннюю информацию, а не только на данные, на которых была обучена языковая модель.