Сотрудники уже пользуются ИИ — вопрос только в том, знает ли об этом компания и где в этот момент оказываются её документы. В ChatGPT можно отправить договор на проверку, фрагмент клиентской базы или внутренний регламент и получить ответ за несколько секунд. Но риск утечек при таком варианте — максимальный.
Для бизнеса проблема начинается не с самого ИИ, а с отсутствия понятных правил: какие данные можно передавать внешним сервисам, а какие должны оставаться внутри компании. Разберём три сценария — облако, гибрид и on-premise LLM — и посмотрим на них с точки зрения рисков, затрат и контроля.
Что происходит с данными, когда вы отправляете запрос в облачную модель
Представим обычную ситуацию. Сотрудник открывает ChatGPT в браузере и пишет: «Проверь этот договор и найди риски для нашей компании».
Если в запросе есть сам договор, его маршрут выглядит примерно так:
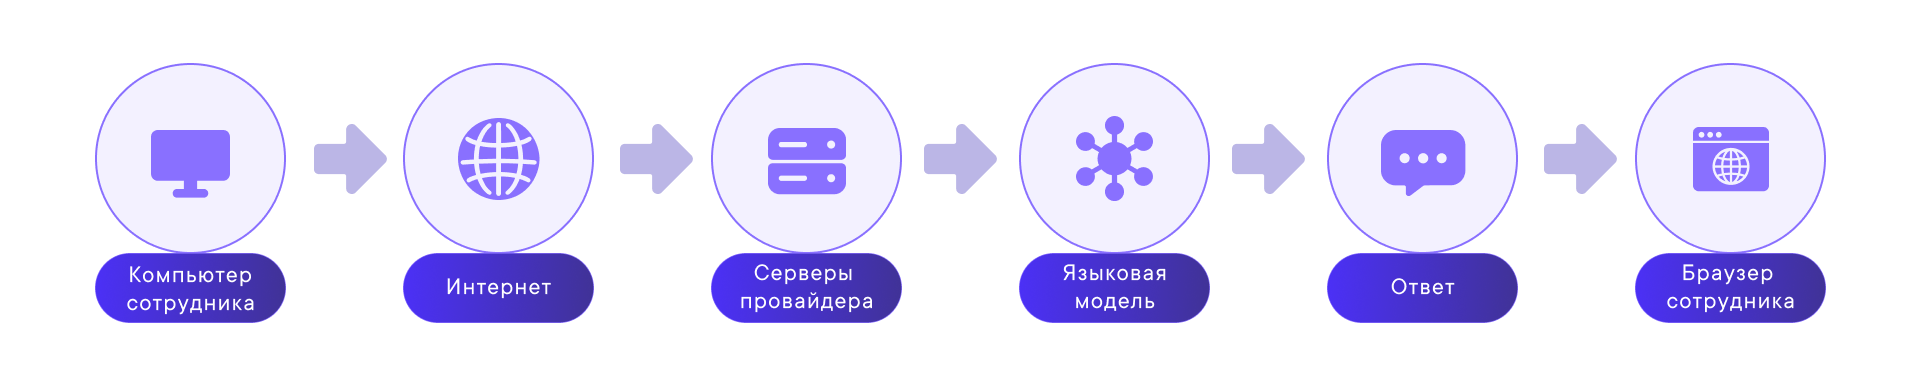
То есть обработка происходит не на компьютере сотрудника и не на сервере компании. Запрос уходит внешнему поставщику сервиса.
И вместе с запросом может уйти гораздо больше, чем кажется. Например:
- текст договора с реквизитами контрагента;
- фрагмент клиентской базы;
- персональные данные сотрудников или клиентов;
- внутренний регламент;
- исходный код;
- финансовые показатели;
- описание ещё не запущенного продукта.
При этом важно не делать из облачных моделей «опасную технологию». Для задач без чувствительных данных они остаются удобным и экономичным инструментом. Проблема возникает тогда, когда компания не установила границу между информацией, которую можно отправлять внешнему сервису, и информацией, которая должна оставаться под её контролем.
Риски не ограничиваются теорией. В 2025 году пользователи обнаружили, что опубликованные через функцию Share диалоги ChatGPT попадали в поисковую выдачу. OpenAI впоследствии отключила возможность делать такие разговоры доступными для поисковых систем, назвав эксперимент источником риска случайного раскрытия информации.
В июле 2026 года похожая ситуация произошла с опубликованными чатами Claude: часть разговоров стала находиться через Google и Bing.
Для руководителя вывод здесь простой: если данные уходят во внешний сервис, компания должна понимать, кто их обрабатывает, какие правила действуют для этих данных и какой контроль остаётся у самой компании.
Именно поэтому у бизнеса постепенно появляется следующий вопрос: можно ли использовать возможности большой языковой модели, но оставить данные внутри собственной инфраструктуры?
Три сценария: облако, гибрид, on-premise
На практике у компании есть три основных варианта.
1. Облачная модель
Сотрудник или приложение обращается к модели через интернет или API. Инфраструктуру, GPU и саму модель предоставляет внешний поставщик.
Подходит: для экспериментов, небольших проектов и задач, где нет чувствительных данных.
Плюсы: быстрый запуск, не нужно покупать серверы и самостоятельно обслуживать инфраструктуру.
Минусы: данные обрабатываются за пределами инфраструктуры компании; стоимость зависит от объёма использования; компания зависит от условий и изменений конкретного поставщика.
Это первый этап развития ИИ во многих компаниях: сотрудники самостоятельно используют ChatGPT с личных аккаунтов, затем ИТ-служба начинает запускать отдельные проекты через облачные API.
2. Гибридная модель
Компания разделяет задачи. Чувствительные данные обрабатываются локально, а для менее критичных запросов можно использовать внешние модели.
Например, внутренний документ с персональными данными остаётся внутри компании, а подготовку нейтрального рекламного текста можно передать облачной модели.
Подходит: большинству компаний, которые уже используют ИИ, но пока не готовы полностью переносить его внутрь инфраструктуры.
Плюсы: компромисс между безопасностью, стоимостью и скоростью внедрения.
Минусы: архитектура становится сложнее: необходимо определить, какие данные и задачи идут в локальную среду, а какие — во внешние сервисы.
3. On-premise
On-premise LLM — это языковая модель, которая развёрнута в инфраструктуре самой компании: на собственных серверах, в её дата-центре или в изолированной среде под её контролем.
Запрос сотрудника в этом случае не должен уходить к внешнему провайдеру модели:
компьютер сотрудника → инфраструктура компании → локальная LLM → ответ.
Компания сама контролирует доступы, данные, правила безопасности и работу системы.
Подходит: для среднего и крупного бизнеса, который работает с персональными данными, коммерческой тайной, внутренними документами или требованиями к аудируемости.
Плюсы: данные остаются внутри инфраструктуры; затраты можно сделать более предсказуемыми; компания не привязана к одному внешнему поставщику модели.
Минусы: нужны серверы с GPU, инфраструктура, компетенции и время на развёртывание.
Поэтому вопрос обычно стоит не как «что лучше — ChatGPT или локальная нейросеть для бизнеса?», а как какой уровень контроля нужен конкретной компании.
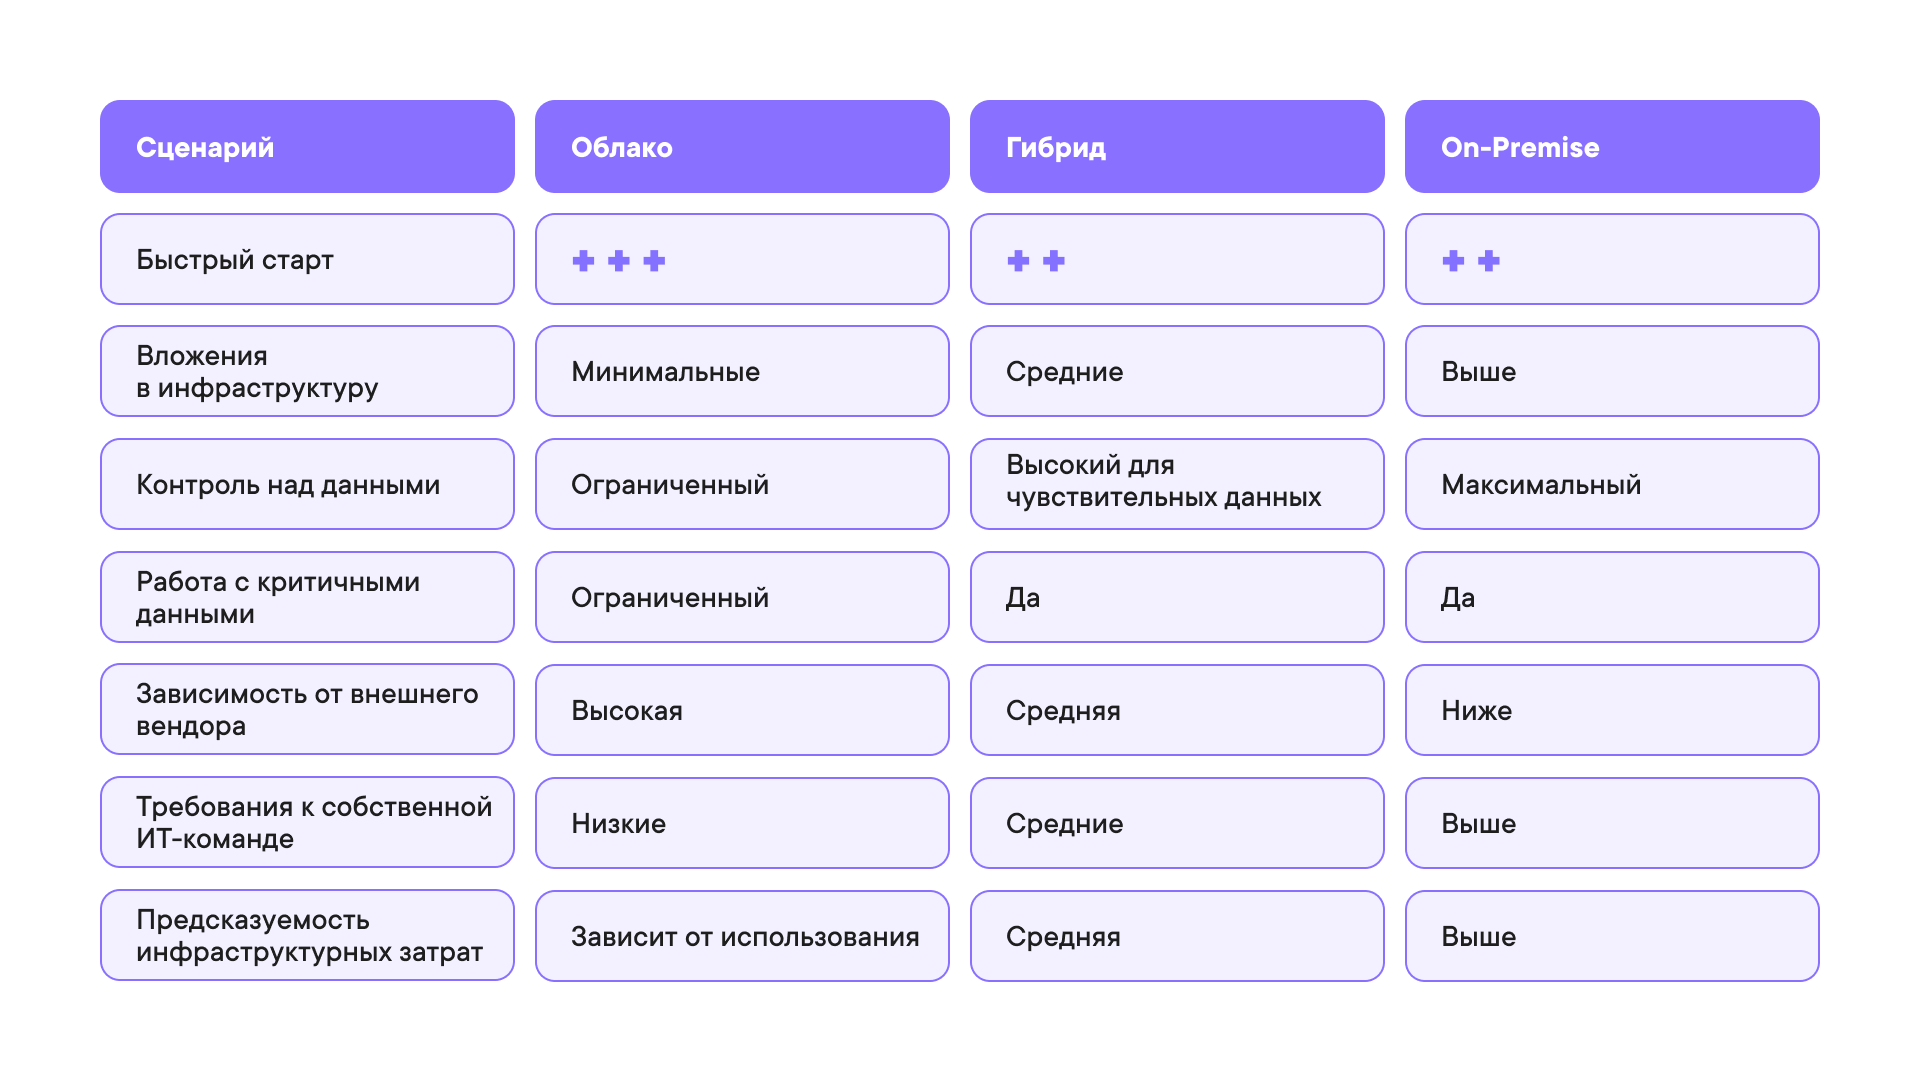
Gorgona AI против облачного ChatGPT: сравнение по 10 критериям
Здесь важно сравнивать не отдельную модель с отдельной моделью, а классы решений: корпоративную AI-платформу, работающую внутри инфраструктуры компании, и облачный AI-сервис.
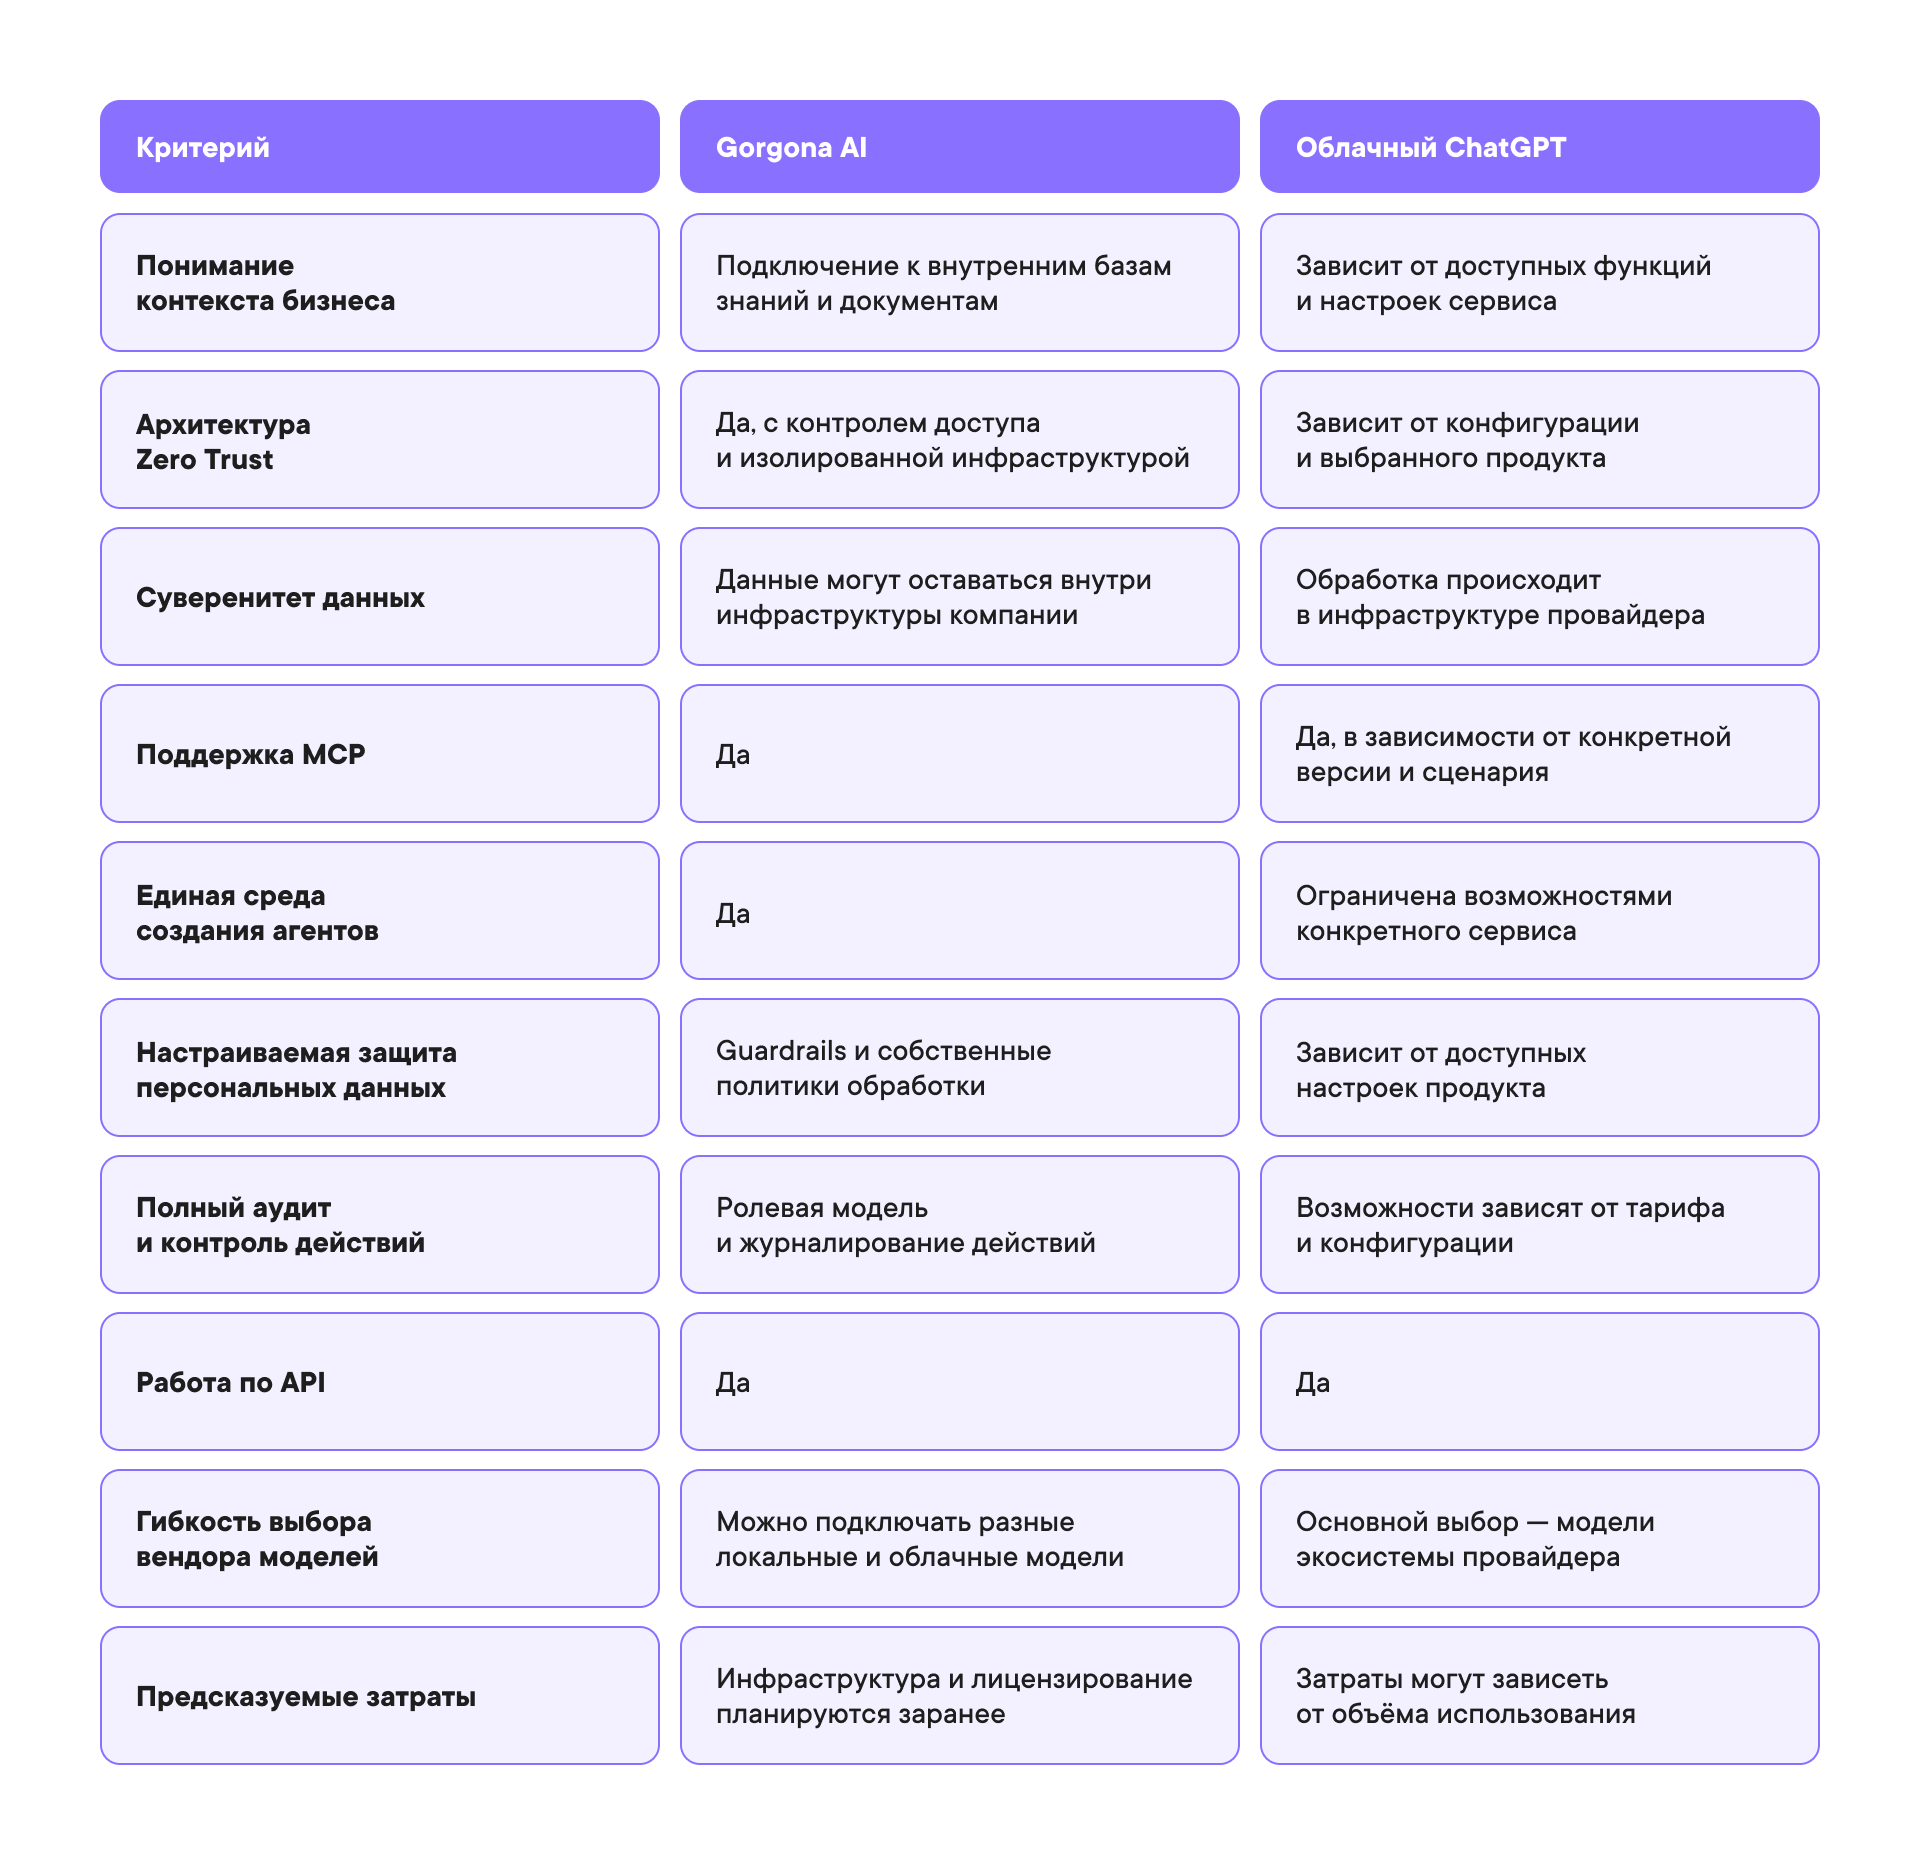
Это не означает, что локальная платформа всегда выигрывает. Облако объективно удобнее там, где важны скорость старта и отсутствие инфраструктурных затрат.
Разница появляется тогда, когда на первый план выходят контроль, безопасность, бизнес-контекст и управляемость ИИ.
Что нужно, чтобы запустить модель внутри компании
Ошибка — считать, что для on-premise достаточно купить мощный сервер и установить на него LLM.
На самом деле корпоративный ИИ состоит как минимум из четырёх слоёв.
1. Инфраструктура
GPU-серверы, CPU, хранилище, сеть, Kubernetes и средства безопасности. Это физическая и системная основа, на которой работает локальная языковая модель.
2. Платформа
Сама LLM — только один элемент. Нужны база знаний и RAG, Guardrails, ASR/OCR, оркестрация, единый интерфейс и API, мониторинг и другие компоненты.
3. Studio
Визуальный конструктор, в котором можно собирать ИИ-агентов под конкретные задачи без разработки каждого сценария с нуля.
4. Готовые агенты
Именно здесь появляется бизнес-эффект: агент поддержки, HR-агент, помощник для работы с документами, аналитикой, комплаенсом или внутренними знаниями компании.
Если собирать такой стек самостоятельно, приходится интегрировать множество отдельных продуктов: GPU и инфраструктуру, модели, RAG, оркестрацию, мониторинг, фильтры безопасности, инструменты для агентов и интеграции с корпоративными системами. Каждый компонент нужно поддерживать отдельно.
Именно поэтому компании выбирают готовые платформы, а не пытаются самостоятельно собрать «зоопарк» технологий.
В Gorgona эта архитектура объединена в единую платформу: от инфраструктуры и моделей до конструктора агентов и готовых решений под бизнес-процессы.
Сам путь внедрения можно разделить на три этапа:
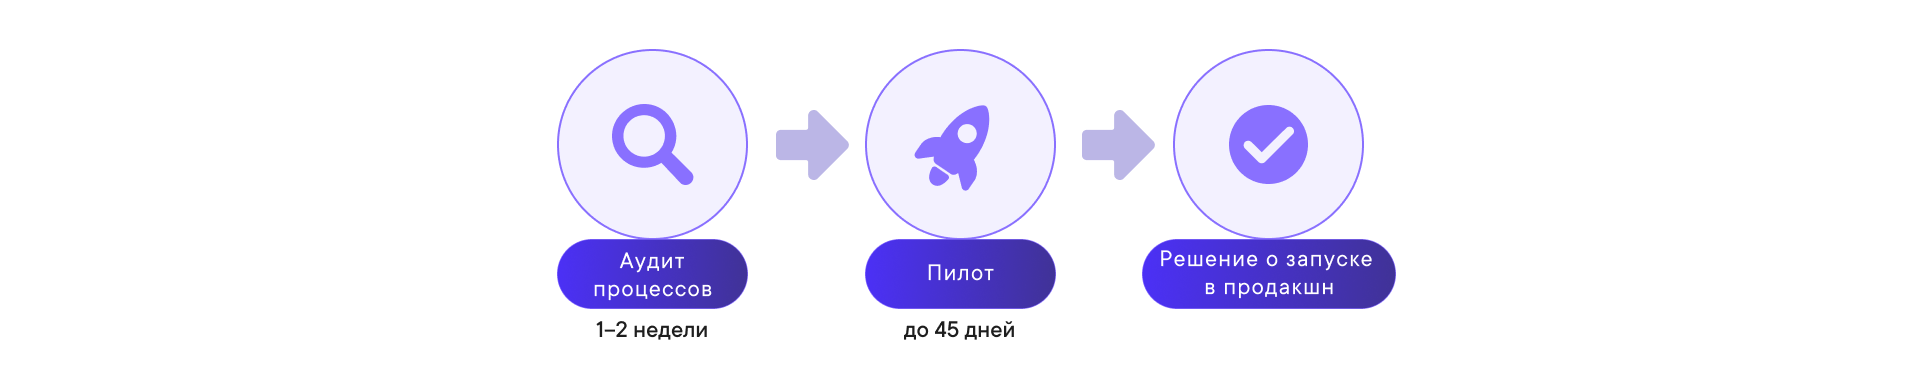
Пилот можно провести на оборудовании Gorgona: данные подключаются через защищённый канал, а после тестирования компания принимает решение о дальнейшем масштабировании. Если решение не показывает нужного эффекта, стороны расходятся без обязательств.
Что происходит с безопасностью внутри контура
Локальное размещение — это не просто физическое нахождение сервера в офисе или дата-центре.
Безопасная корпоративная AI-система должна контролировать, кто, к чему, когда и что именно получает доступ.
В Gorgona это включает:
- данные не покидают инстанс;
- ролевая модель ограничивает доступ сотрудников и агентов;
- каждое действие журналируется;
- Guardrails контролируют данные на входе и выходе;
- телеметрия хранит метрики нагрузки, латентности и ошибок, но не промпты, персональные данные и содержимое запросов.
Такой подход важен не только для предотвращения утечек. Он позволяет объяснить, как именно ИИ используется внутри компании, кто имеет к нему доступ и какие действия система выполняет.
Когда on-premise не нужен
Локальная языковая модель — не универсальное решение для любой компании.
Облако может быть разумнее, если:
- компания небольшая;
- сотрудники работают только с открытой информацией;
- чувствительных данных в AI-сценариях нет;
- объём запросов небольшой;
- нет собственной ИТ-команды для поддержки инфраструктуры;
- ИИ используется преимущественно для экспериментов и простых задач.
В таком случае покупка серверов и создание собственной инфраструктуры может оказаться дороже, чем облачная подписка или API.
Поэтому хороший подход начинается не с вопроса «какую LLM установить?», а с аудита процессов и данных.
Как понять, что вам пора переходить к корпоративному ИИ
Ответьте на шесть вопросов:
- Попадают ли персональные данные клиентов или сотрудников в запросы к ИИ?
- Используют ли сотрудники ChatGPT и другие нейросети с личных аккаунтов?
- Есть ли процессы, в которых ИИ должен работать с внутренними документами или базами знаний?
- Требует ли ваша отрасль аудируемости действий и контроля доступа к данным?
- Растут ли расходы на облачные AI API по мере увеличения числа проектов?
- Нужны ли компании определённые языки, модели или специализированные сценарии, которые сложно реализовать в одном внешнем сервисе?
Если на несколько вопросов ответ «да», компания уже проходит путь от экспериментов к корпоративному внедрению.
Обычно он выглядит так:
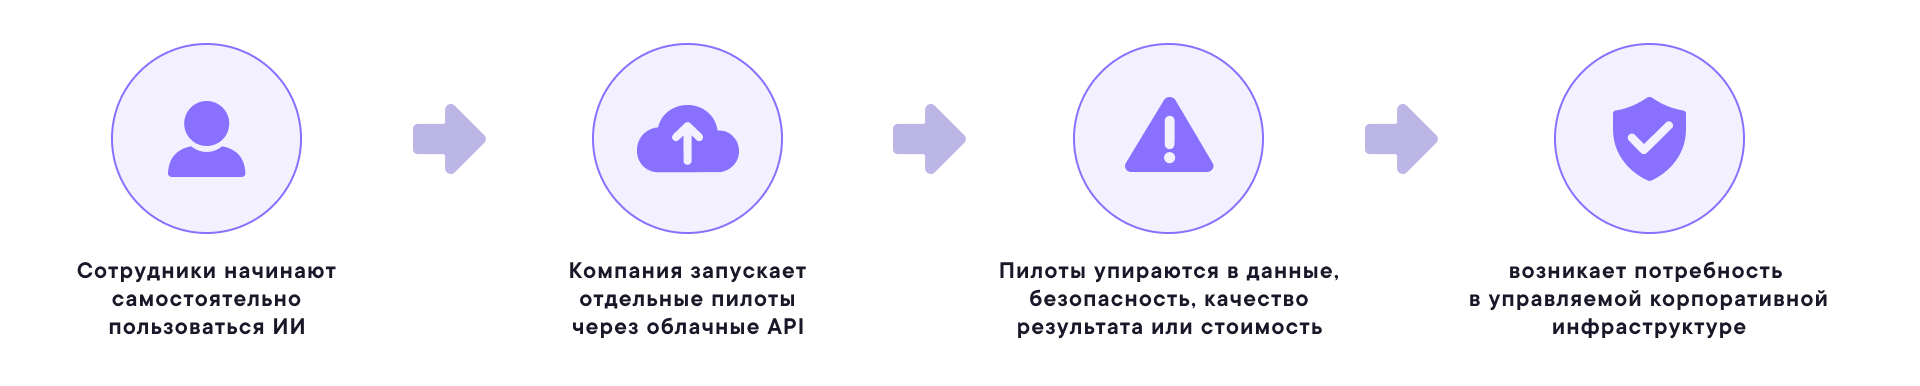
On-premise LLM — следующий шаг не потому, что «локальная модель лучше ChatGPT». Она нужна тогда, когда ИИ становится частью критичных бизнес-процессов, а вместе с ним возрастает цена потери контроля.
Запросить пилот Gorgona
Не обязательно сразу покупать серверы, менять архитектуру и переносить все AI-процессы компании.
Начните с одного процесса. Команда Gorgona проведёт аудит, поможет выбрать сценарий для пилота и до 45 дней покажет работу корпоративного ИИ на реальной задаче и на оборудовании Gorgona.
Запросите пилот Gorgona AI — и проверьте, какой сценарий внедрения подходит именно вашей компании. Запросить пилот Gorgona AI