Языковая модель не знает ваших документов — она обучалась на другом массиве данных. Спросить её про внутренний регламент без дополнительного контекста — примерно как попросить прохожего рассказать о правилах вашей компании. При этом модель может не отказаться отвечать, а сформировать правдоподобный, но неверный ответ. Разберём, что такое RAG, как он помогает подключить корпоративные знания к ИИ и что нужно, чтобы поиск по внутренним документам действительно работал.
Почему модель не знает ваших документов
Большая языковая модель получает знания во время обучения. В этот момент она формирует способность работать с текстом, находить закономерности и генерировать ответы. Но документы, которые появились внутри вашей компании вчера, в её обучающем корпусе не находятся.
Можно попробовать дообучить модель на корпоративных данных. Но для большинства задач это дорогой и сложный путь: модель нужно обучать на новых данных, а за изменениями знаний — следить. Кроме того, дообучение не решает задачу быстрого и прозрачного обновления информации.
Есть другой подход: не менять саму модель, а дать ей нужные знания непосредственно в момент запроса.
Именно здесь появляется RAG — Retrieval-Augmented Generation, или генерация с дополнением контекста найденной информацией.
RAG сначала ищет в базе знаний фрагменты, которые соответствуют вопросу пользователя, а затем передает их языковой модели вместе с запросом. Модель формирует ответ уже с учетом найденного контекста.
Поэтому RAG часто используют как основу для поиска по документам с помощью ИИ, корпоративной базы знаний и ИИ-поиска по внутренним документам.
Как устроен RAG: три шага
Процесс можно представить так:
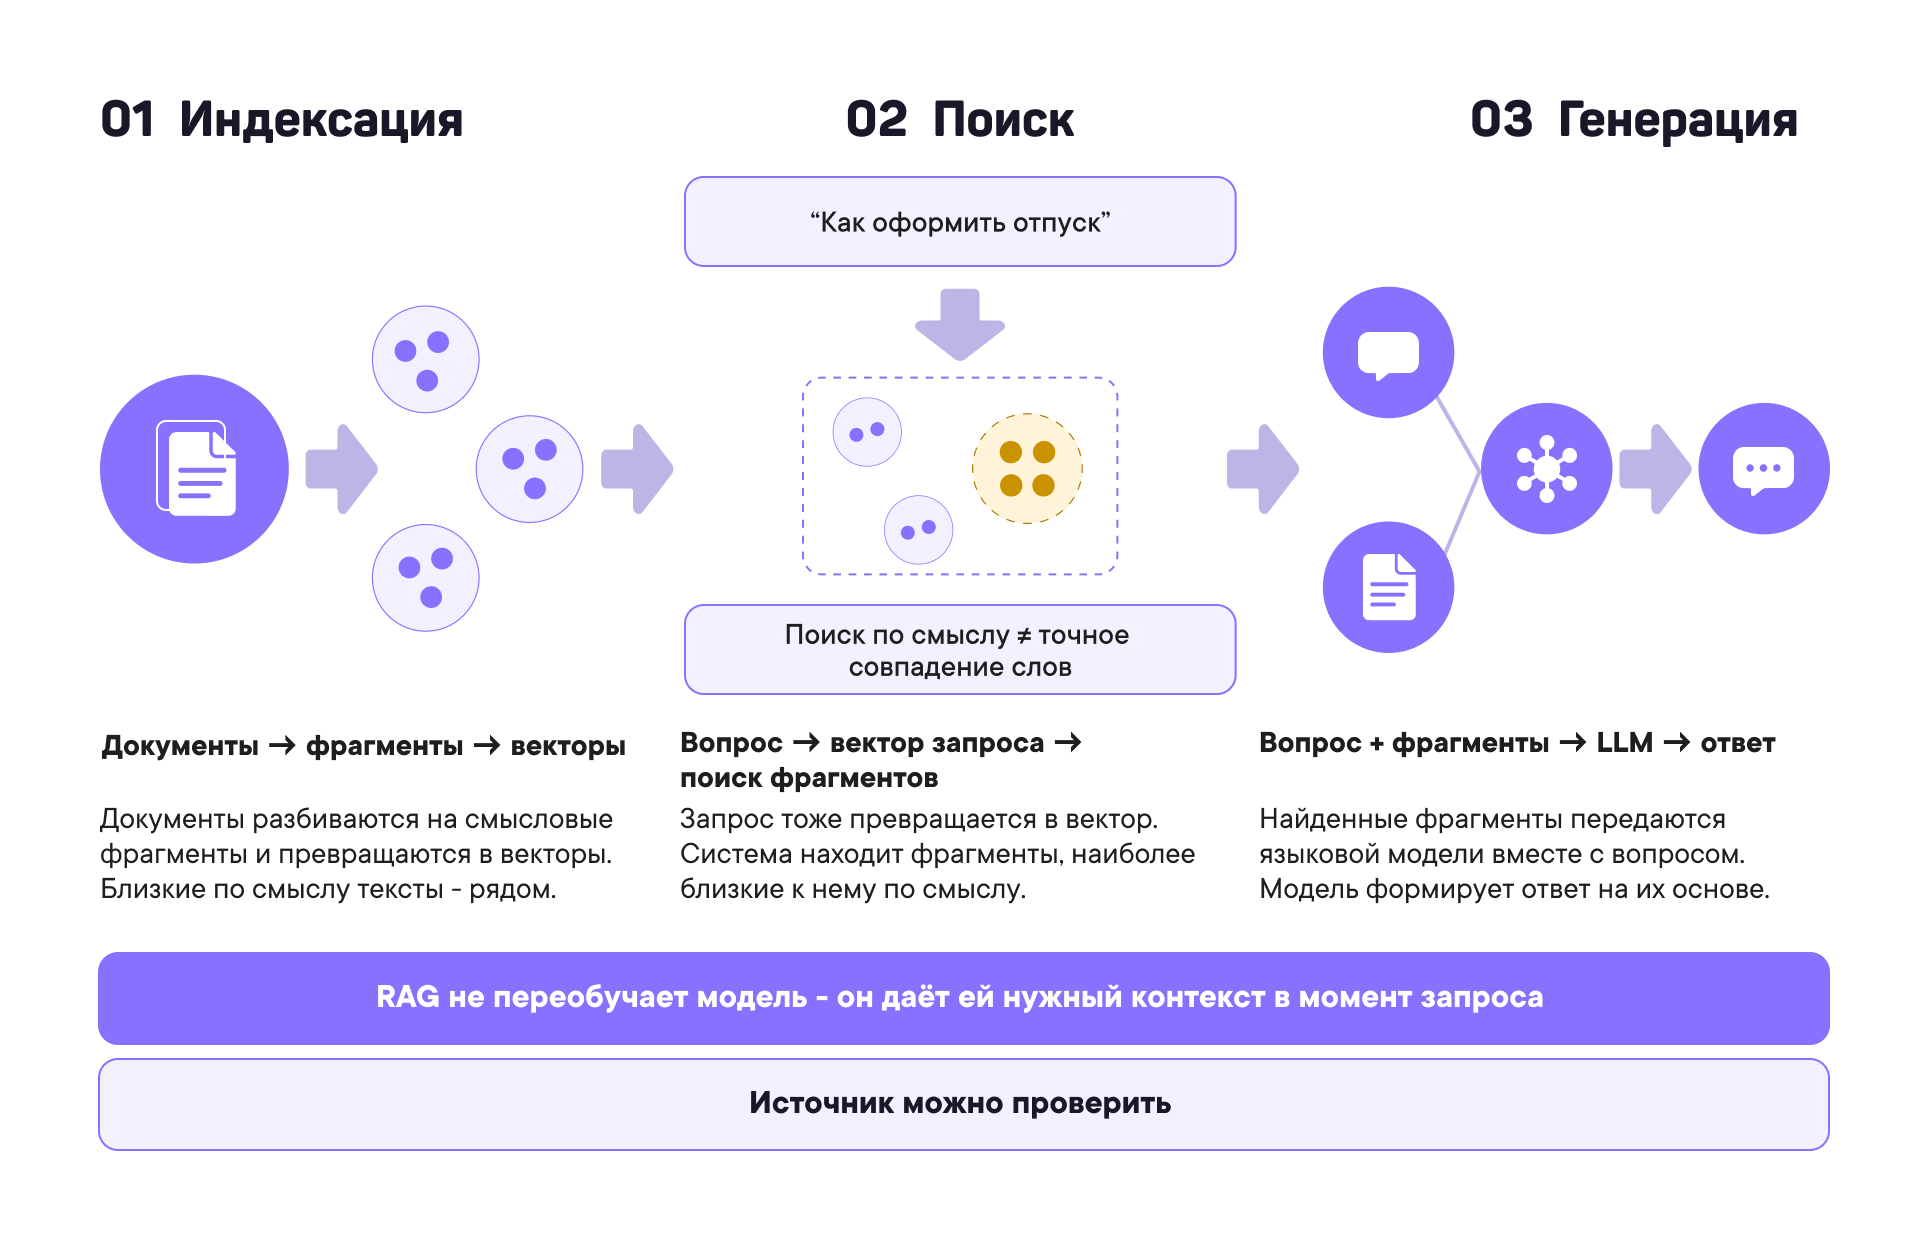
Шаг 1. Индексация
Сначала документы нужно подготовить к поиску.
Большой документ разбивается на небольшие смысловые фрагменты — чанки. Затем каждый фрагмент преобразуется embedding-моделью в числовое представление — вектор. Условно его можно представить как точку или стрелку в многомерном пространстве: близкие по смыслу тексты оказываются рядом.
Важно не просто нарезать документ через каждые 500 или 1000 символов. Границы фрагментов можно определять по структуре текста: заголовкам, разделам, предложениям. Конкретная стратегия зависит от типа документов.
Шаг 2. Поиск
Когда сотрудник задаёт вопрос, запрос тоже превращается в вектор. Система сравнивает его с векторами документов и находит фрагменты, наиболее близкие по смыслу.
Поэтому пользователь может сформулировать вопрос не теми словами, которые написаны в документе.
Например, в документе может быть сказано «емкость для хранения воды», а человек спросит: «Как купить бутылку воды?». Обычный поиск по точному совпадению слов может не связать эти формулировки. Семантический поиск работает с их смысловой близостью.
На практике можно сочетать два подхода: поиск по смыслу и обычный keyword-поиск. Такой гибридный retrieval во многих случаях дает лучший результат.
Шаг 3. Генерация ответа
Найденные фрагменты передаются языковой модели вместе с исходным вопросом.
У модели появляется дополнительный контекст: она получает не только знания, полученные во время обучения, но и конкретную информацию из корпоративной базы.
На её основе модель формирует понятный для человека ответ.
Именно поэтому RAG — это не «обучение ChatGPT вашим документам». Это механизм, который в момент запроса находит релевантные данные и дает модели контекст для ответа.
Что Knowledge Engine делает поверх базового RAG
Сам по себе RAG решает задачу поиска релевантных фрагментов. Но в корпоративной среде возникает следующий вопрос: что именно искать, кому это можно показать и как поддерживать базу знаний в рабочем состоянии?
Knowledge Engine — модуль платформы Gorgona, который организует работу с корпоративными знаниями и добавляет к базовому RAG необходимые механизмы управления ими.
Права доступа
В компании не существует единой базы, которую должны видеть все сотрудники.
У разработчика может быть доступ к технической документации, у юриста — к договорам, у бухгалтера — к финансовым документам. Руководитель при этом может иметь более широкий доступ.
В Knowledge Engine документы организованы в структуру база знаний → коллекции → документы, а права можно задавать для команд. Перед поиском система определяет команду пользователя и ограничивает поиск теми базами знаний и коллекциями, к которым у него есть доступ.
Это принципиальное отличие корпоративного ИИ-поиска от простой RAG-базы: модель не должна получать контекст из документов, которые конкретному сотруднику запрещено видеть.
При этом данные конкретного заказчика находятся в его собственной инфраструктуре — база знаний устанавливается во внутреннем контуре компании, а не становится общей базой для разных организаций.
Поддержание базы знаний
Корпоративные документы меняются. Регламент обновили, инструкцию заменили, старый файл удалили — система должна учитывать эти изменения.
За базой знаний работает отдельная роль Data Steward. Такой специалист загружает документы, распределяет их по коллекциям, настраивает права, проверяет результаты поиска и следит за качеством данных.
Важен и сам процесс загрузки. У Gorgona есть базовые коннекторы к корпоративным системам, в том числе Jira, Confluence и Google Drive. Для нестандартного источника может потребоваться отдельный коннектор.
Разные типы документов
Универсальной настройки RAG не существует.
Для разных типов данных может отличаться стратегия нарезки, размер чанков, embedding-модель и способ извлечения информации. Например, структуру Markdown-документов можно использовать при нарезке, тогда как для другого типа файлов эффективнее будет другая стратегия.
В Knowledge Engine эти параметры можно настраивать под конкретную базу знаний.
Поддерживаются распространенные форматы, включая PDF, DOCX, HTML и Markdown. Для нестандартных форматов или особых структур данных может потребоваться дополнительная настройка.
Пять ошибок внедрения, из-за которых RAG может не работать
RAG — не кнопка «подключить документы». Качество ответа напрямую зависит от того, какие данные попали в систему и как они подготовлены.
1. Плохая нарезка документов
Если чанк обрывается посреди мысли, в него не попадает важный контекст или вместе оказываются несвязанные части документа, поиск может вернуть фрагмент, который формально похож на запрос, но не помогает ответить на него.
Поэтому стратегию chunking выбирают с учетом структуры конкретных документов.
2. Устаревшие и противоречивые данные
Если в базе одновременно находятся действующий регламент и старый черновик, система может найти оба документа. Модель не знает автоматически, какой из них компания считает актуальным.
Отсюда важный принцип: качество ответа начинается с качества корпоративных данных.
3. Игнорирование прав доступа
Если права не учитывать на этапе retrieval, сотрудник потенциально может получить информацию из закрытого документа.
Поэтому разграничение доступа должно происходить до поиска, а не после того, как модель уже получила контекст.
4. Отсутствие оценки качества
Фраза «ответ выглядит правдоподобно» не является метрикой качества.
Для проверки можно создавать golden set — набор вопросов с заранее известными правильными ответами. Затем систему прогоняют по этому набору и сравнивают полученные ответы с эталонными. Так можно сравнивать разные настройки RAG и видеть, какая из них лучше работает на конкретной базе знаний.
5. Ожидание стопроцентной точности
В работе с ИИ нет универсальной настройки, которая гарантирует одинаковый результат для любых данных.
Цель внедрения — не обещать ноль ошибок, а измерять качество, понимать его ограничения и быстро находить причины деградации. Для этого полезны трассировка запросов и анализ того, какие данные попали в контекст ответа.
RAG или дообучение: что выбрать?
Если компании нужно, чтобы ИИ знал актуальные внутренние документы и отвечал на их основе, чаще подходит RAG.
Главное преимущество — знания можно обновлять без повторного обучения языковой модели. Добавили новый документ — он становится частью базы знаний после обработки и индексации.
Дообучение решает другую задачу. Оно может быть оправдано, когда нужно изменить поведение модели, её стиль или формат ответов. Но для постоянно меняющихся корпоративных фактов использовать обучение модели как замену поиску по актуальным документам обычно менее удобно.
С чего начать внедрение
Для первого пилота не нужно сразу переносить в ИИ весь корпоративный архив.
Начать можно даже с одного документа — например, инструкции или базы ответов для конкретного подразделения. Затем проверить, насколько хорошо система находит информацию, настроить поиск и только после этого расширять базу знаний.
На практике важно заранее определить:
- какой бизнес-процесс должен улучшить ИИ;
- какие документы содержат необходимые знания;
- где они сейчас хранятся;
- кто должен иметь к ним доступ;
- кто будет отвечать за актуальность базы знаний;
- как будет оцениваться качество ответов.
Так RAG превращается из эксперимента с чат-ботом в рабочий инструмент.
Knowledge Engine в составе Gorgona объединяет поиск по корпоративным знаниям, управление базами документов, разграничение доступа и инструменты для проверки качества. А сама платформа разворачивается в инфраструктуре заказчика, что позволяет работать с внутренними данными в контролируемом контуре.
Если вы хотите понять, как ИИ-поиск по внутренним документам может работать именно в вашей компании, запросите демо Gorgona. На демо можно разобрать ваши источники данных, сценарий использования и требования к доступам — и определить, с какого набора знаний разумнее начать пилот.