Til modellari (LLM) o'zbek tilidagi matn uchun xuddi ingliz tili kabi bir xil token narxini qo'llaydi, ammo o'zbek matnini ko'proq tokenlarga ajratadi. Biz ushbu xarajat farqini yirik provayderlardan tortib open-source modellargacha bo'lgan 15 ta tokenizer yordamida tekshirib ko'rdik, bu farq nimalarga bog'liq ekanligini tahlil qildik va yangi alifbo joriy etilishi ushbu ko'rsatkichlarga qanday ta'sir qilishini hisoblab chiqdik.
Asosiy xulosalar
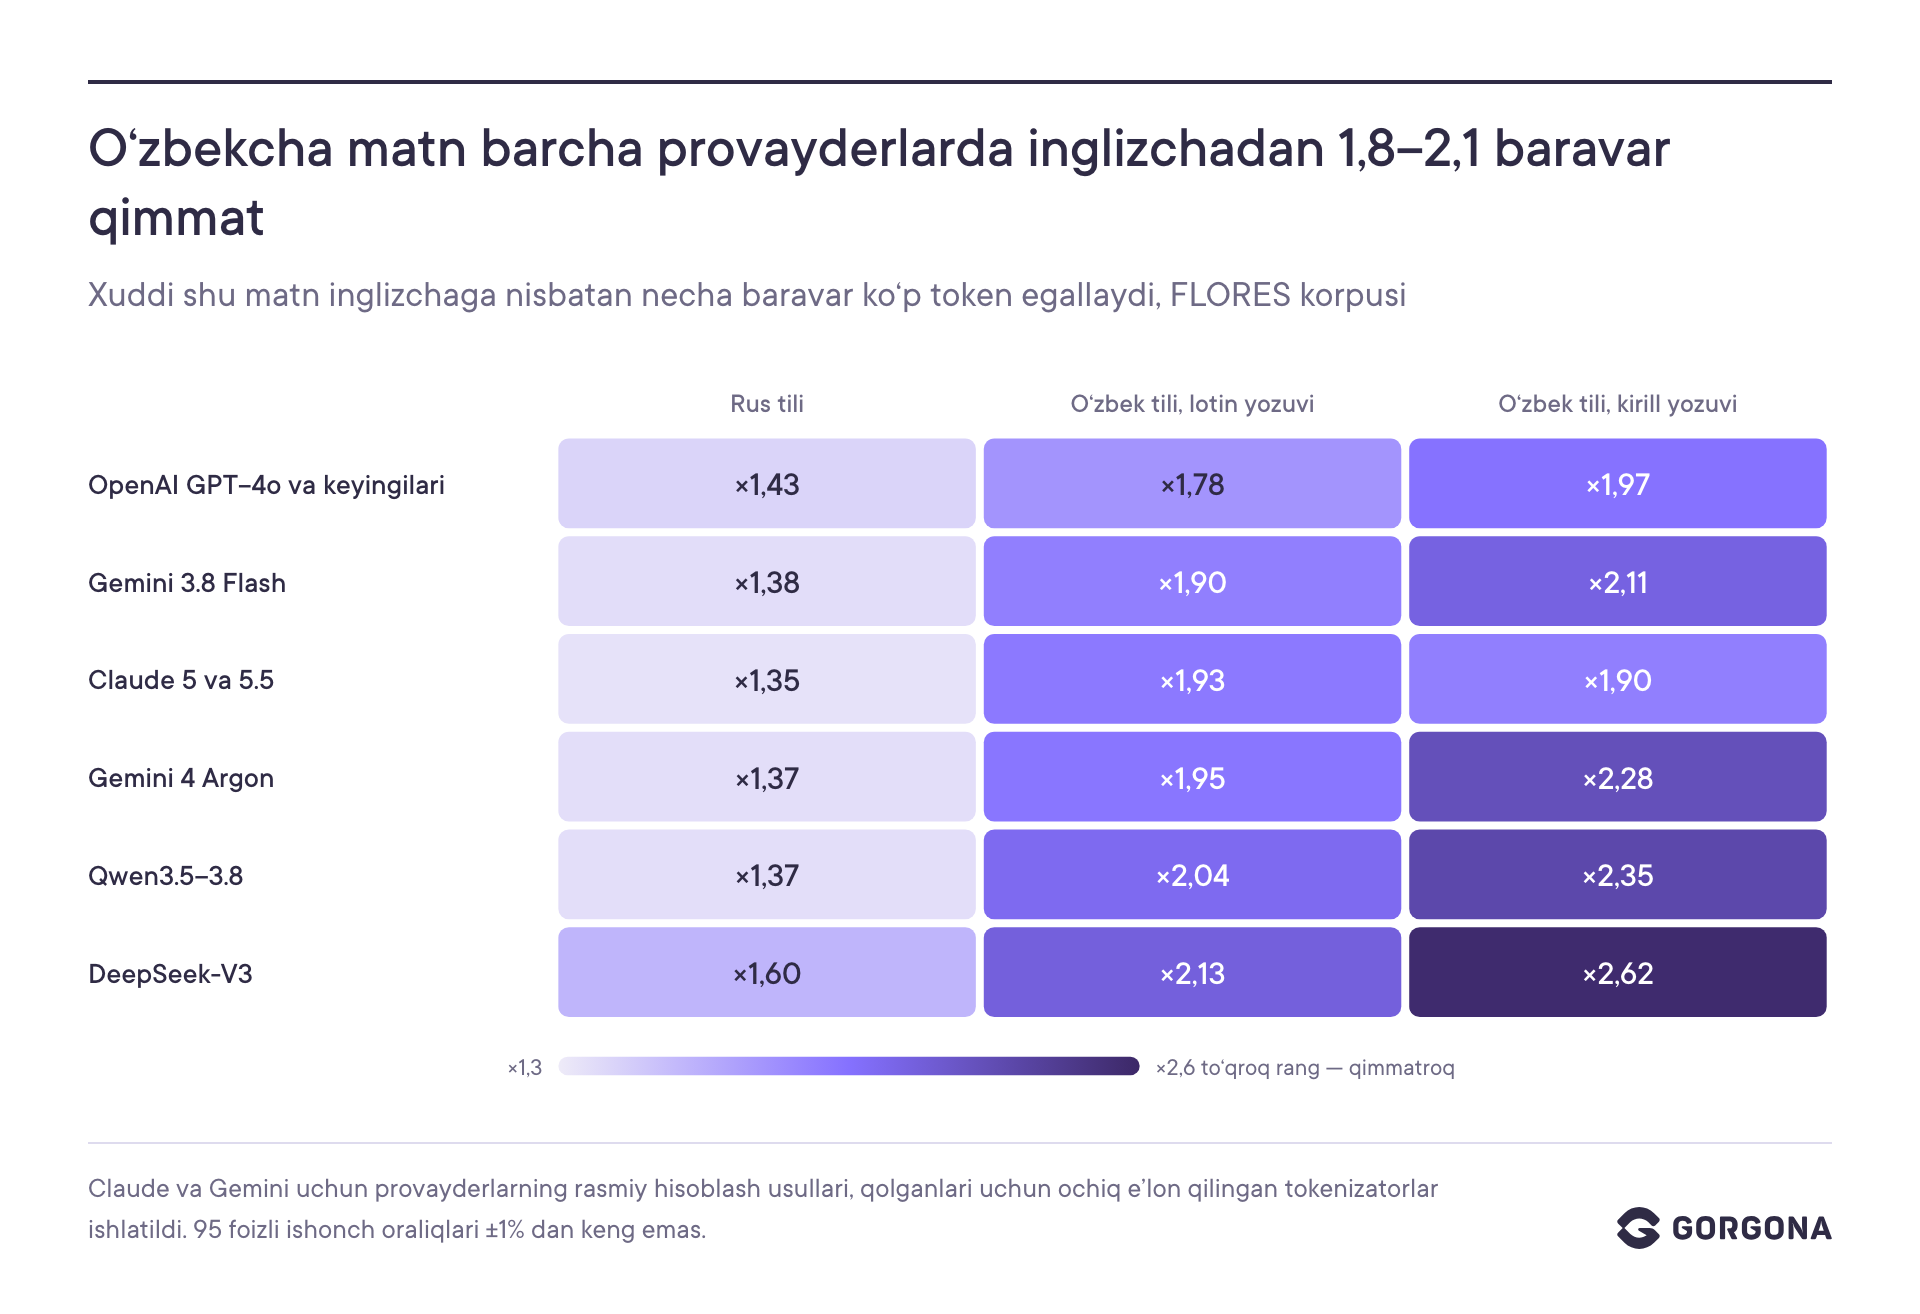
- Lotin yozuvidagi o‘zbekcha matn beshala providerda (OpenAI, Anthropic, Google, Qwen va DeepSeek) xuddi shunday hajmdagi ingliz tilidagi matnga nisbatan 1,55–2,17 barobar ko‘proq token talab qiladi. Tokenlar soni bo‘yicha quyi chegara asl o‘zbek tilida yozilgan matnlarga, yuqori chegara esa ingliz tilidan tarjima qilingan matnlarga to‘g‘ri keladi
- Rus tiliga nisbatan o‘zbek tili modelga qarab 1,24–1,54 barobar qimmatroq tushadi. Matn janri bu nisbatga deyarli ta’sir qilmaydi va har bir modelda bu ko‘rsatkich 8% dan ko‘p o‘zgarmaydi
- Lotin yozuvi kirill alifbosiga qaraganda tejamkorroq: aksariyat provayderlar uchun lotin yozuvidagi o‘zbekcha matn taxminan 6-19% kamroq token egallaydi, Claudeda esa ikkala alifbo ham bir xil qiymatga ega.
- Javoblar ham so‘rovlar (promptlar) kabi qimmatlashadi: o‘zbek tilidagi ko‘rinadigan javob (visible output) ingliz tilidagiga qaraganda 1,7–1,8 barobar qimmatroq. Claude Haiku 3.5 maxsus sozlamasiz yashirin mulohazalarni (hidden reasoning / chain of thought) avtomatik ishga tushirgan va buning natijasida to‘lanadigan javob narxi 2,1–2,3 barobar oshgan.
- Claude Opus 5.5 va GPT-5.6 Sol bir xil narx siyosatiga ega bo‘lsa-da, bir xil o‘zbekcha matnni Claude’da qayta ishlash 1,7 barobar qimmatroqqa tushadi, chunki uning tokenizeri matnni ko‘proq tokenlarga ajratadi. Shuning uchun modellarni faqat token narxi bo‘yicha emas, balki o‘z matningiz uchun kelib chiqadigan yakuniy qiymat bo‘yicha solishtirish kerak.
- Yangi alifboga o‘tilgandan so‘ng, beshta yirik providerda tokenlar soni deyarli o‘zgarmaydi (chetlanishlar ikkala tomonga ham 4% dan oshmaydi), shuning uchun bu o‘tish AI xizmatlaridan foydalanishda qo‘shimcha xarajatlar keltirib chiqarmaydi
- O‘zbek tili uchun qo‘shiladigan narx ustamasi uning ona tili sifatida so‘zlashuvchilar soni bilan emas, balki modellar o‘qitish jarayonida qancha o‘zbekcha matnlarni "ko‘rganligi" bilan belgilanadi. Shuning uchun open-source o‘zbek korpuslari raqamli infratuzilma sifatida ishlaydi: ular qancha ko‘p bo‘lsa, startuplardan tortib davlat organlarigacha bo‘lgan barcha tashkilotlar uchun o‘zbek tilidagi AI-xizmatlar shunchalik arzon va, ehtimol, sifatliroq bo‘ladi.
- Yangi alifboni oldindan ma’lumotlar bazasi bilan ta’minlash kerak. Hozircha yangi yozuvdagi matnlar kamligi sababli, modellar uni eski alifboga qaraganda yomonroq tushunadi. Ikkala yozuvdagi parallel korpuslar, open-source konverterlar va yagona matn kiritish qoidalarini 2027-yil aprelidan keyin emas, balki shundan oldin tayyorlab qo‘yish maqsadga muvofiq.
- Bir o‘zingiz bu ishni uddalay olmaysiz. Korpuslar, morfologik lug‘atlar, tokenizatorlar va o‘zbek tilidagi sifat testlari faqat kompaniyalar, universitetlar va davlatga birgalikda, model ishlab chiquvchilar bilan muloqotda mavjud.
Hisoblash metodologiyasi, qanday matnlar va modellar ishlatilgani, shuningdek, ularning har biri bo‘yicha olingan aniq natijalar to‘liq versiyada batafsil bayon qilingan.
Nima uchun bir xil ma’no turli xarajatlarga olib keladi?
Til modellari (LLM) matnni so‘zlar bilan emas, balki tokenlar bilan o‘qiydi va yozadi; ya’ni, tokenizer matnni ajratadigan alohida fragmentlarga bo‘ladi. Providerlar barcha tillar uchun har bir token bo‘yicha yagona tarif asosida to‘lov undiradi, ammo turli tillarda bir xil ma’noni ifodalash uchun ketadigan tokenlar soni har xil bo‘ladi. Ingliz tilidagi so‘z odatda bitta tokenni egallaydi, chunki modellarni o‘qitish (training) uchun ishlatilgan ma’lumotlar bazasida (dataset) aynan ingliz tili eng ko‘p uchraydi. Model o‘qitish jarayonida kamroq uchragan tildagi so‘z esa bir nechta fragmentlarga bo‘linib ketadi, natijada uning uchun ko‘proq to‘lov qilishga to‘g‘ri keladi.
Tadqiqotchilar tillarning notekis tokenlarga ajralishini hali 2019 – 2021-yillarda payqashgan, biroq o‘sha paytda bu holat faqat sifat (quality) masalasi sifatida qaralgan. Bu hodisa 2023-yilda haqiqiy iqtisodiy masalaga aylandi, aynan shu yili til modellari (LLM) har bir token uchun to‘lov olinadigan tijorat xizmatlariga aylandi. Aynan shu davrda birinchi atamalar ham paydo bo‘ldi: dastlab tokenization premium (ya’ni, "tokenizatsiya uchun qo‘shimcha ustama"), keyinchalik esa token tax ("token solig‘i") atamalari keng qo‘llanila boshlandi.
«Token solig‘i» qayerdan kelib chiqadi?
Tillar o‘rtasidagi farq uch guruh sabablardan iborat bo‘lib, har bir til uchun ular o‘ziga xos tarzda birikadi.
Birinchi guruh ma’lumotlar bilan bog‘liq. Tokenizer lug‘ati u o‘qitilgan matnlar asosida shakllantiriladi; o‘qitish jarayonida tez-tez uchragan so‘zlar va ularning bo‘laklari yagona, yaxlit tokenlarga aylanadi. Bu o‘rinda muhim bo‘lgan narsa tilni ona tili sifatida so‘zlashuvchilar soni emas, balki internetda ushbu tilda qancha matn yaratilganligidir. Hind, bengal va urdu tillari dunyodagi eng keng tarqalgan tillar qatoriga kirsa-da, yirik modellarning tokenizerlari ularni qayta ishlashda ingliz tiliga nisbatan 3–4 barobar ko‘proq token sarflaydi. Xitoy va birma tillari — ikkalasi ham lotin yozuviga asoslanmagan tillar — 2023-yilda GPT-4 tokenizeri uchun ingliz tiliga qaraganda mos ravishda 1,9 va 11,7 barobar qimmatroqqa tushgan. Buning sababi oddiy: o‘qitish ma’lumotlarida xitoycha matnlar juda ko‘p, birma tilidagilari esa deyarli yo‘q.
Ikkinchi sabab tokenizerning arxitekturasi (tuzilishi) bilan bog‘liq: u qaysi algoritm asosida qurilganligi, uning lug‘ati hajmi qanchaligi va u o‘qitishdanoldin matnni qanday qilib dastlabki bo‘laklarga ajratishi (pre-tokenization) muhim ahamiyatga ega. Tadqiqotchilar Janubi-Sharqiy Osiyoning 11 ta tili uchun bir xil ma’lumotlar to‘plami asosida tokenizerlarni o‘qitganlarida, faqatgina algoritmni o‘zgartirishning o‘zi tillar orasidagi xarajat farqini taxminan uchdan bir qismga qisqartirgan. Providerlarning texnik yechimlari ham xuddi shunday ta’sir ko‘rsatadi: masalan, OpenAI GPT-4 tokenizeridan GPT-4o tokenizeriga o‘tganida, uning lug‘atidagi kirill alifbosiga oid tokenlar soni deyarli 20 barobar oshdi, natijada ukrain tilidagi matnni qayta ishlash narxi 41% ga arzonlashdi.
Uchinchi omil tilning o‘ziga xos lingvistik xususiyatlari bilan bog‘liq: affikslar zanjiridan tashkil topgan uzun so‘zlar, yozuv tizimi va bir xil harflarning turli xil yozilish (ortografik) variantlari.
Masalan, so‘zlar affikslar zanjiri orqali hosil qilinadigan Suahili va Zulu tillarida modellar bitta so‘zni qayta ishlash uchun o‘rtacha 2,6–2,8 ta token sarflaydi. Yozuv tizimi ham katta ta’sir ko‘rsatadi: agar turk tillaridagi matnlarni kirill va arab yozuvidan yagona lotin yozuviga o‘girish (transliteratsiya) orqali qayta ishlanrsa, tokenlar soni 22–41% ga qisqaradi.
Biroq, asosiy iqtisodiy afzallik lotin yozuvida emas, balki internetda ko‘proq uchraydigan yozuv tizimidadir: masalan, lotin yozuvidagi ukrain tili, aksincha, 2–19% ga qimmatlashadi. Shuni ta’kidlash kerakki, tilning o‘ziga xos xususiyatlari uni faqatgina modelning lug‘ati ushbu tilni yetarli darajada o‘rganmagan taqdirdagina ’qimmat’ qiladi. Masalan, turk tili ham so‘zlarni affikslar zanjiri orqali hosil qiladi, ammo u modellarga o‘zbek tiliga qaraganda sezilarli darajada arzonroqqa tushadi.
Tokenizator ko‘zi bilan o‘zbek tili
O‘zbek tilida taxminan 40 million kishi so‘zlashadi va u turk tillari orasida so‘zlashuvchilar soni bo‘yicha turk tilidan keyin ikkinchi o‘rinda turadi. Biroq, til modellari nuqtai nazaridan, bu til bir vaqtning o‘zida bir nechta jihatdan noqulay xususiyatlarga ega.
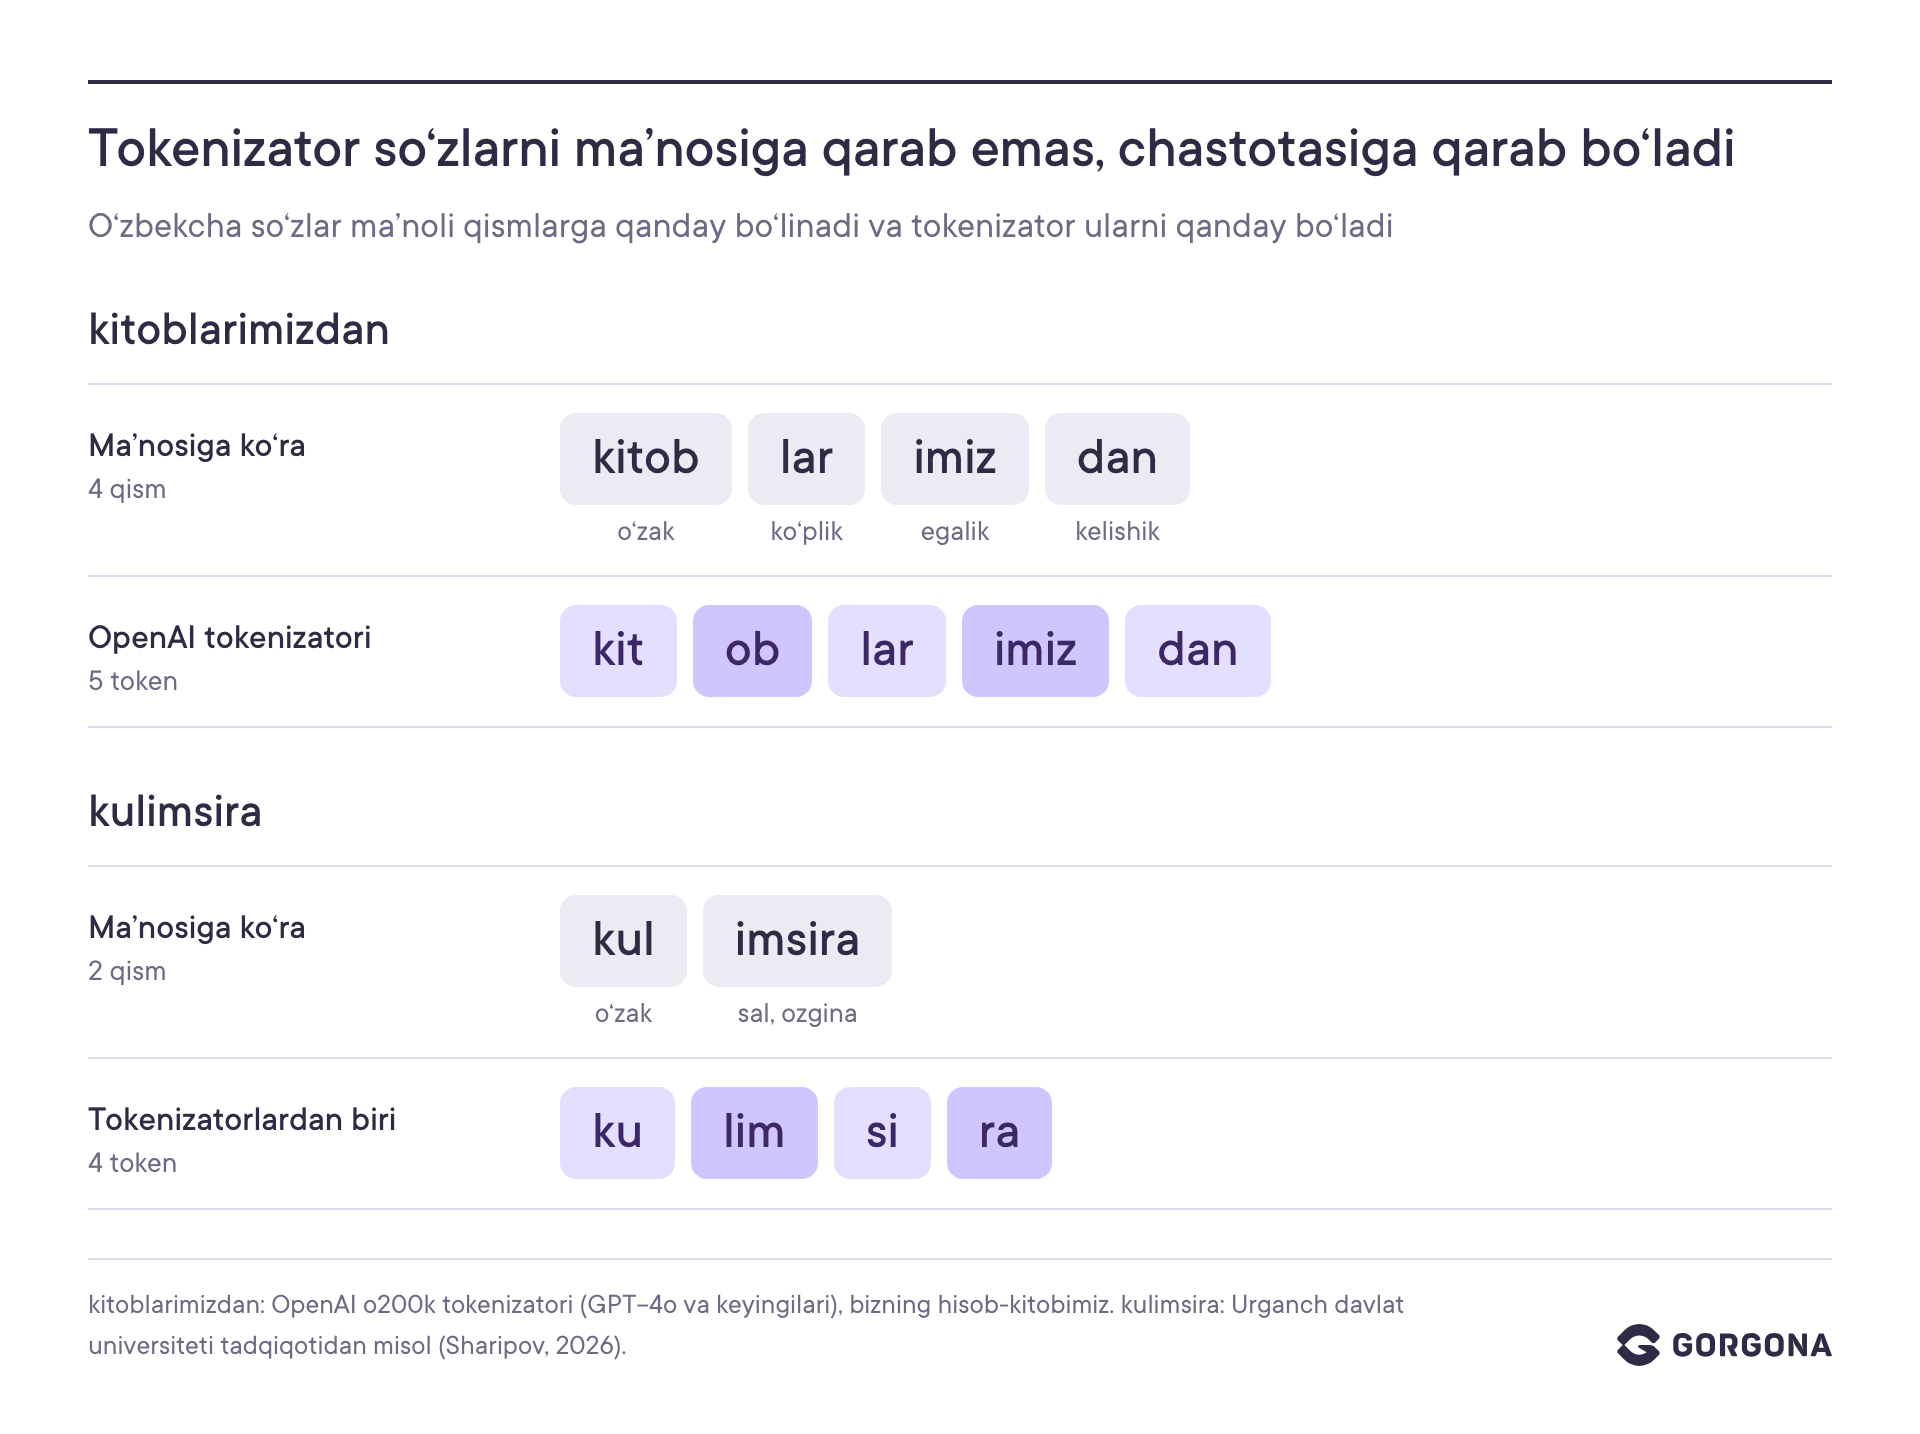
Avvalo, o‘zbek tilida so‘zlarning qanday shakllanishiga e’tibor qaratish lozim. Bu til agglyutinativ (yopishqoq) xususiyatga ega, ya’ni so‘z o‘zak va affikslar zanjiridan yig‘iladi, ularning har biri ma’lum bir grammatik ma’noni qo‘shadi. Masalan, kitoblarimizdan so‘zi kitob o‘zagidan hamda ko‘plik, tegishlilik va chiqish kelishigi (yo‘nalish) affikslaridan tashkil topgan bo‘lib, bitta shunday so‘z uchta inglizcha so‘zning ma’nosini o‘zida mujassam etadi.
Agar modelning lug‘ati ushbu qismlarni "tanimasа", tokenizer so‘zni uning semantik tuzilishiga qarab emas, balki faqat statistik chastotaga asoslanib ajratadi. Masalan, Urganch davlat universiteti olimlari tomonidan o‘tkazilgan tadqiqotda kulimsira fe’li ku, lim, si va ra kabi alohida bo‘laklarga parchalanib ketgani, natijada kul o‘zagidan hech qanday iz qolmagani qayd etilgan.
Navbatdagi omil — alifbo masalasi, u ham bir vaqtning o‘zida ikkita. 1940-yildan boshlab o‘zbek tili kirill yozuvida yozilgan, 1993-yilda esa mamlakat rasman lotin yozuviga o‘tgan, biroq kirill yozuvi hali ham keng qo‘llanilmoqda.
Modellar uchun bu befarq narsa emas: bizning o‘lchovlarimizda bir xil matn kirill yozuvida lotin yozuviga qaraganda 7–23% ko‘proq token egalladi (Anthropicdan tashqari barcha providerlar uchun). Lotin yozuvida esa o‘ va g‘ harflari mavjud bo‘lib, ulardagi maxsus belgi to‘rt xil turli simvol bilan yozilishi mumkin, tokenizer uchun esa ularning har biri mutlaqo alohida belgi hisoblanadi. Bundan tashqari, standart tokenizerlar ushbu belgini tinish belgisi sifatida qabul qilib, so‘zni aynan shu joydan uzadi; natijada o‘zbek so‘zi "o", "apostrof" va "zbek" kabi uchta alohida qismga ajralib qoladi. Bizning hisob-kitoblarimizda faqatgina ushbu belgini tanlashning o‘zi tokenlar sonini 5% gacha o‘zgartirgan.
Biroq, bu farqni faqat grammatika va alifbo bilan to‘liq tushuntirib bo‘lmaydi. Turk tili ham xuddi shunday agglyutinativ tuzilishga ega va lotin yozuvida yoziladi, ammo xuddi shu 30 ta gapni GPT-4o turk tilida qayta ishlash uchun 609 ta token sarflagan bo‘lsa, o‘zbek tilida bu ko‘rsatkich 763 ta tokenni tashkil etdi (ya’ni 20% ga ko‘proq).
Asosiy farqni tokenizer lug‘ati yaratadi: lug‘atiga o‘zbek tili maxsus kiritilgan modellar o‘zbek tilidagi matnni qayta ishlashda xuddi ingliz tili uchun sarflanadigan tokenlar soniga yaqin miqdorni talab qiladi.
Alifbo islohotida nimalarni o‘zgartirish kerak
2026-yil 21-oktyabrda Prezident yangi o‘zbek alifbosi to‘g‘risidagi qonunni imzoladi va 2027-yil 22-apreldan boshlab o‘, g‘, sh va ch harflari o‘, g‘, ş va ç harflarini almashtiradi (O‘zbekiston Respublikasining 2026-yil 21-oktyabrdagi O‘RQ-1184-sonli Qonuni). Islohotning asosiy maqsadlaridan biri tilni raqamli muhitda rivojlantirish ekanligi e’lon qilingan, shu sababli mantiqiy savol tug‘iladi: ushbu o‘zgarish o‘zbek tilini AI tizimlari uchun arzonroq qiladimi?
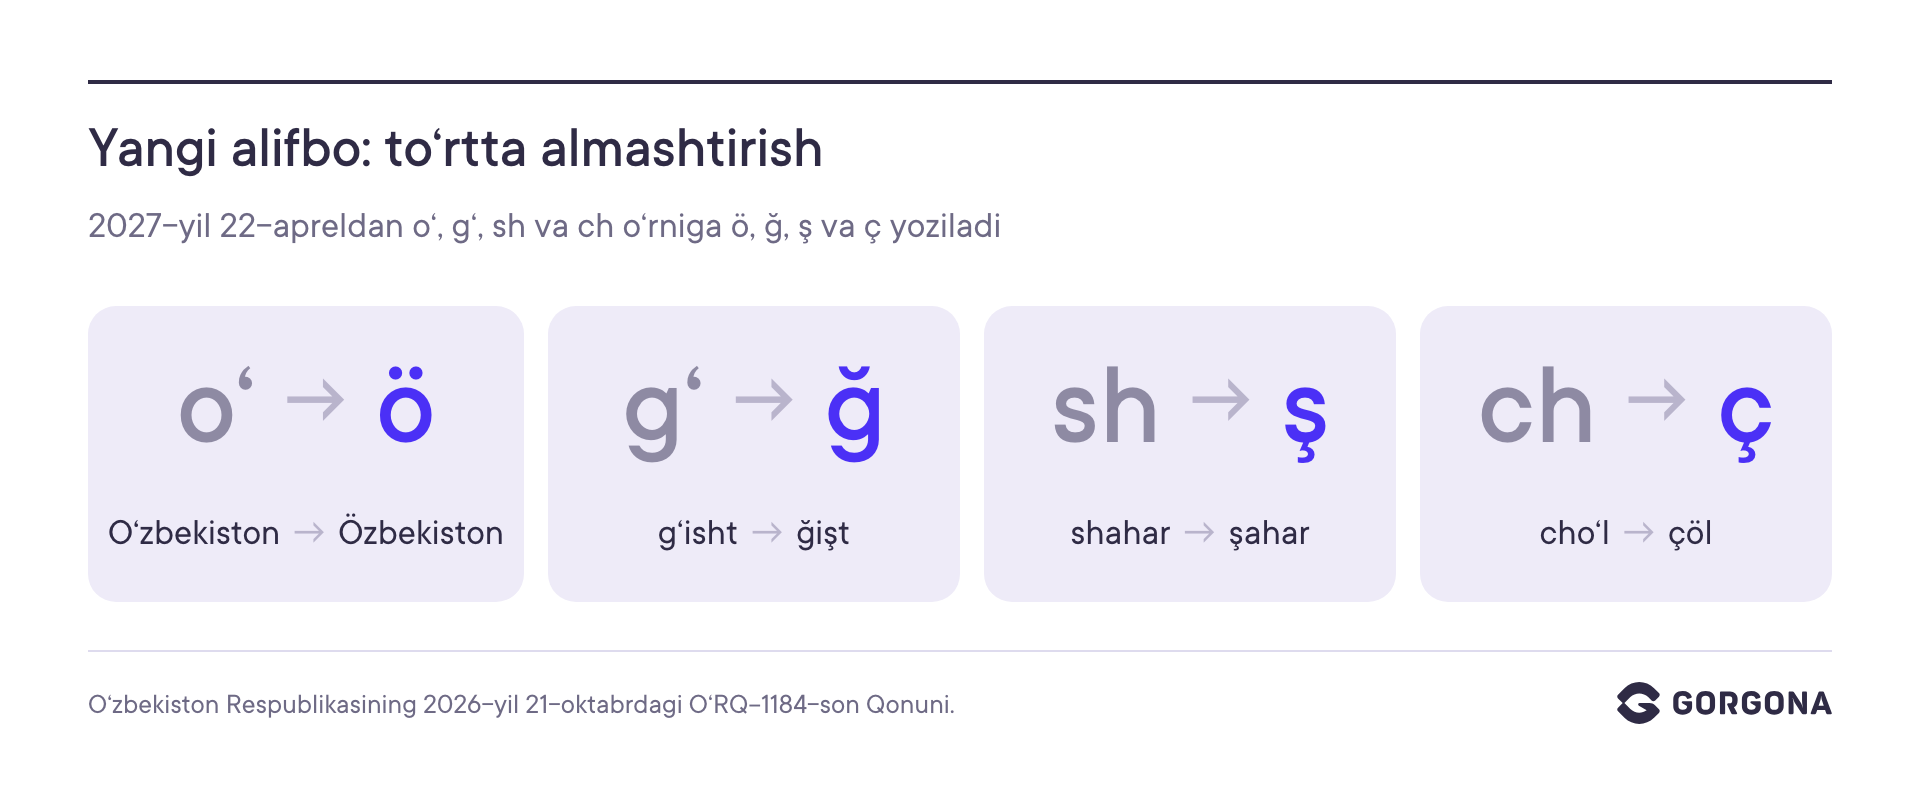
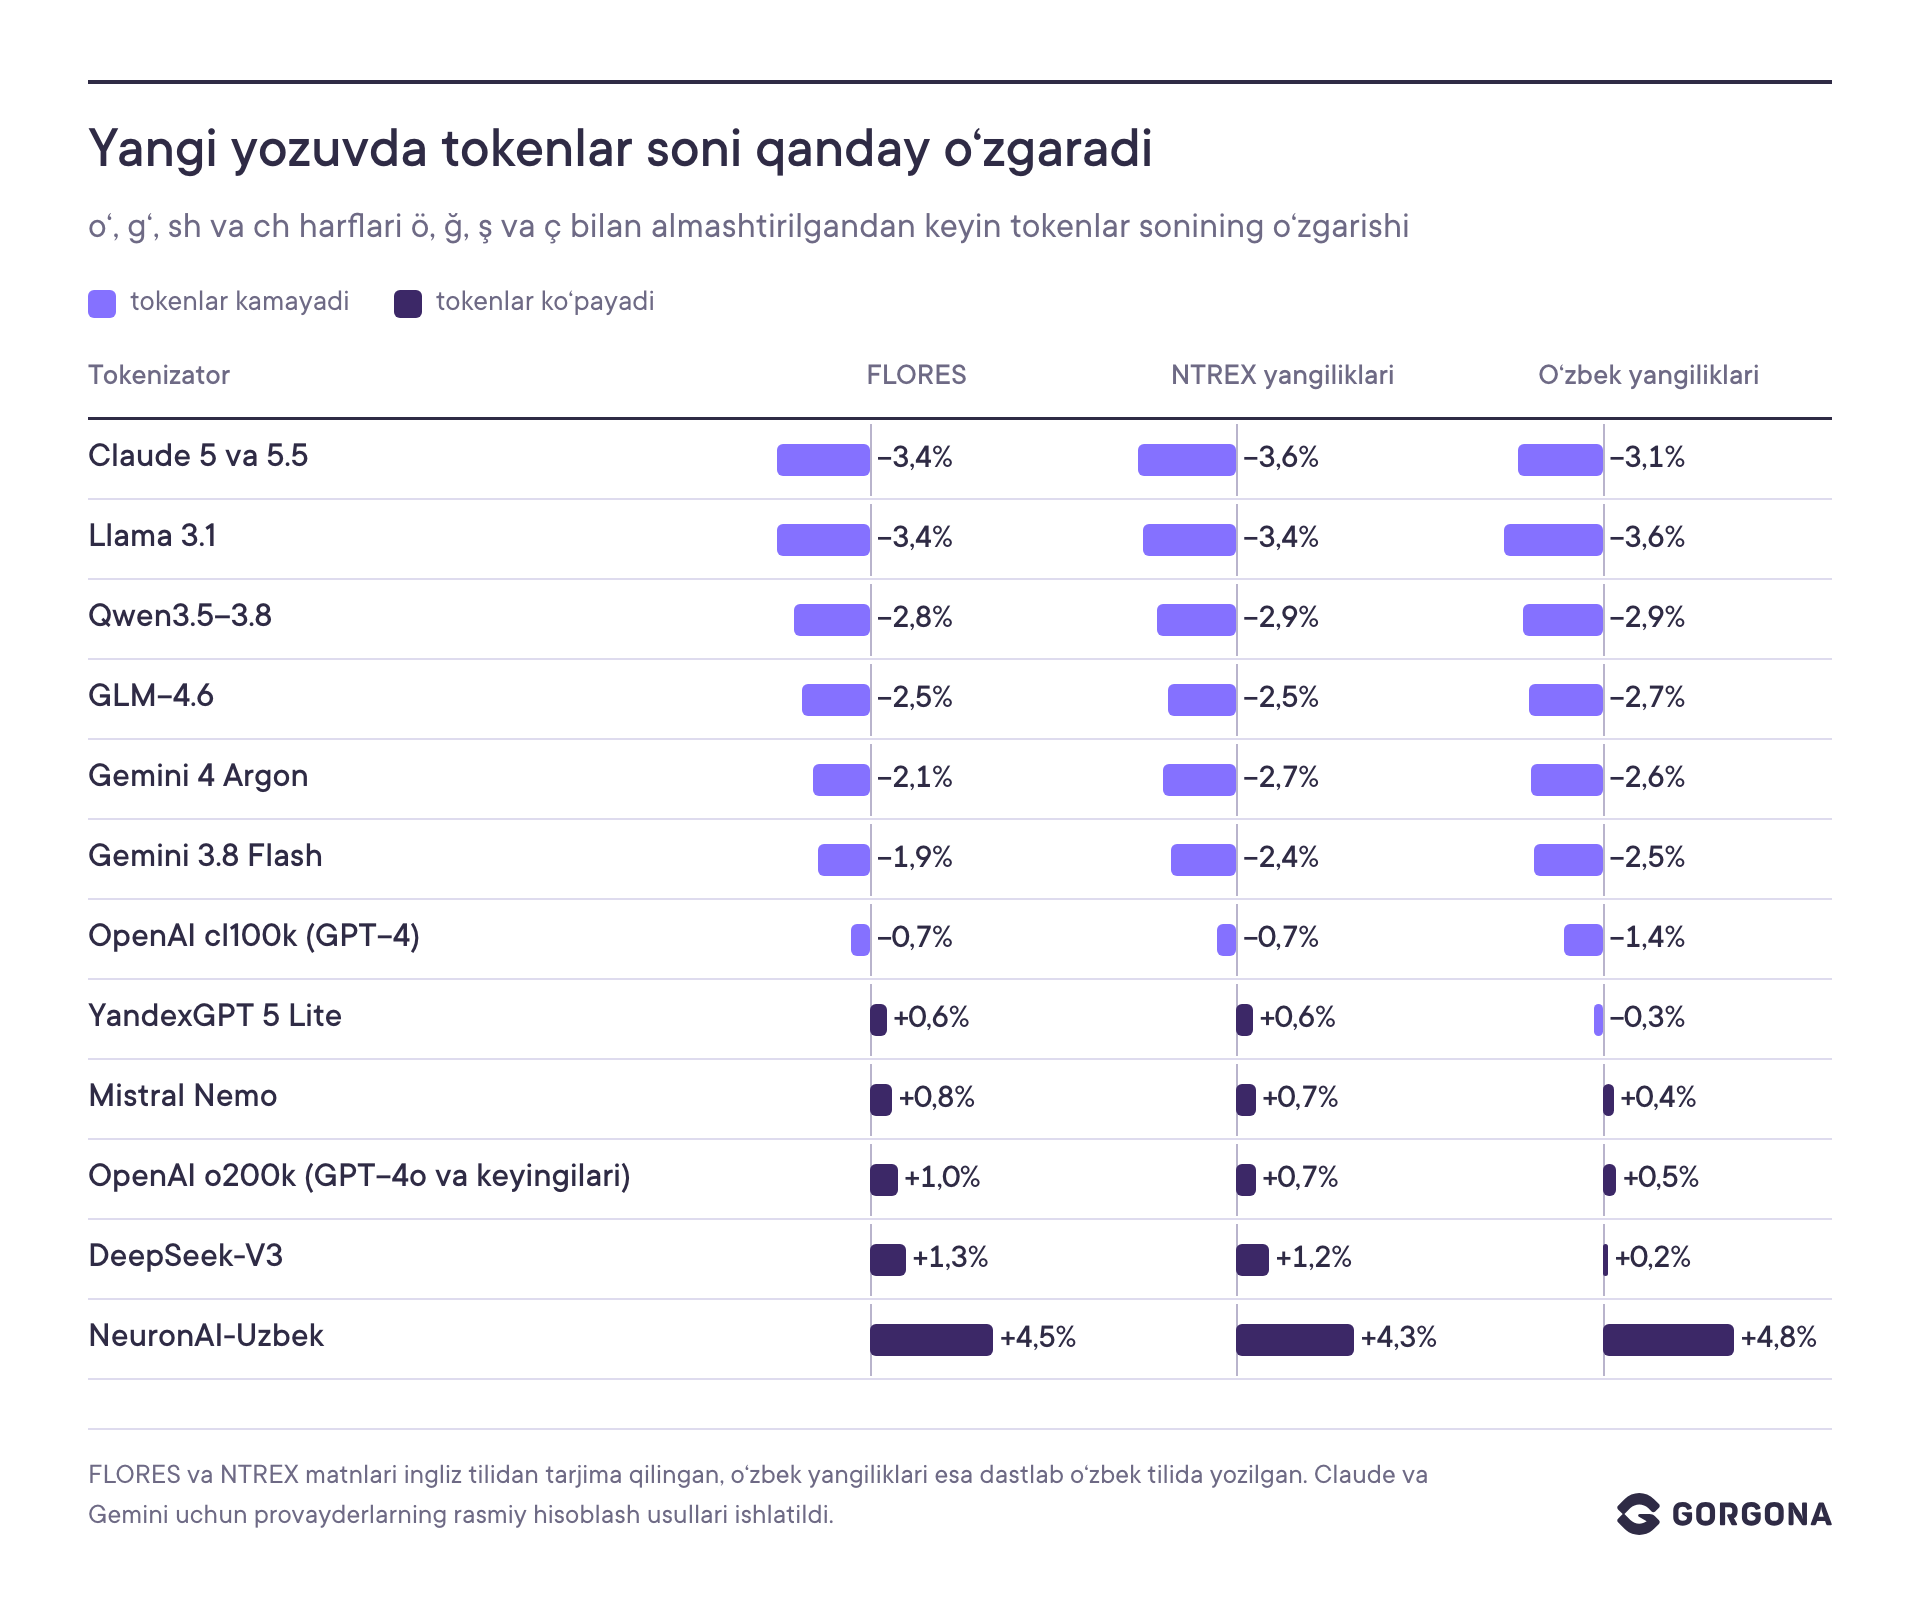
Biz buni barcha matnlarimizdagi harflarni yangi yozuvga almashtirish orqali tekshirib ko‘rdik. Yangi yozuvdagi matn belgilar (simvollar) soni bo‘yicha haqiqatan ham 4% ga qisqaradi, ammo bu tokenlar soniga deyarli aks etmaydi. Yirik providerlar uchun tokenlar soni 4% dan ko‘p o‘zgarmaydi: shu bilan birga, Claude, Gemini va Qwenda bu ko‘rsatkich biroz kamayadi, OpenAI va DeepSeek modellarida esa, aksincha, biroz ortadi.
Minus islohotdan keyin tokenlar kamayishini, plyus esa koʻpayishini bildiradi.
Islohotning yana bir qo‘shimcha ijobiy oqibati ham mavjud: o‘ va g‘ harflari o‘zgarishi bilan birga, hozirda 5% gacha ortiqcha token xarajatini keltirib chiqarayotgan to‘rt xil apostrof variantlari bilan bog‘liq chalkashlikka ham barham beriladi.
Uzoq muddatli istiqbolda esa ko‘p narsa internetda yangi yozuvdagi matnlar qanchalik tez to‘planishiga bog‘liq. Lotin yozuviga o‘tayotgan Qozog‘iston tajribasi shuni ko‘rsatadiki, dastlab yozuv tizimini o‘zgartirish tokenizerlar yangi matnlar bazasi asosida qayta o‘qitilmaguncha (retraining), modellar bilan ishlash xarajatlarini hatto oshirishi ham mumkin.
Nima uchun umumiy raqamlar yetarli emas?
O‘zbek tilidagi matnlarning o‘qitish ma’lumotlari da yetarli darajada yo‘qligi ushbu xarajatlar farqining faqat bir qismini tushuntiradi. Qolgan qismini esa texnik yechimlar belgilaydi: yirik modellarning tokenizerlari asosan ingliz tili ustunlik qiladigan matnlar bazasida va aynan shu tilning tuzilishiga moslashtirilgan holda shakllantirilgan.
Shu sababli, biror til uchun chiqarilgan xulosalarni shunchaki boshqa tilga mexanik ravishda ko‘chirib bo‘lmaydi. Har bir tilni uning barcha o‘ziga xos xususiyatlari bilan alohida o‘rganishga to‘g‘ri keladi: so‘zlarning qanday shakllanishidan tortib, apostrofning qaysi aniq simvol bilan yozilishigacha.
Tilning amaliyotda qanday qo‘llanilishi ham kam ahamiyatga ega emas. O‘zbek tilida ham lotin, ham kirill yozuvidan foydalaniladi, o‘ va g‘ harflaridagi apostrof esa qanday to‘g‘ri kelsa, shunday (turli xil simvollar bilan) kiritiladi. Faqat shu omilning o‘ziyoq tokenlar sonini bir necha foizga o‘zgartirib yuboradi.
Vaziyatni bundan ham ko‘proq kompaniya model yordamida hal qilayotgan aniq vazifalar o‘zgartiradi. Bir xil narx siyosatiga ega bo‘lgan ikkita model bir xil matnni qayta ishlash xarajati bo‘yicha 1,7 barobar farq qilishi mumkin. Ingliz tilidagi tizimli prompt o‘zbek tilidagiga qaraganda 1,5–2 barobar kamroq token talab qiladi. Shuningdek, javob berishdan oldin mustaqil ravishda "mulohaza yuritish" rejimiga o‘tadigan model o‘zbek tilidagi javob xarajatlarini yanada oshirib yuborishi mumkin.
Shu sababli, tadqiqotlardagi umumiy raqamlar faqat taxminiy yo‘nalish sifatida foydalidir, ammo haqiqiy xarajatlarni o‘z matnlari