1. Nima uchun SIga korporativ bilimlar kerak
Til modeli ma'lumotlarni tahlil qilishi va savollarga javob berishi mumkin, ammo o'z-o'zidan kompaniyaning ichki reglamentlari, dolzarb ko'rsatmalari va korporativ hujjatlarini bilmaydi.
Sun'iy intellekt (SI) ushbu bilimlardan ish jarayonida foydalana olishi uchun RAG (Retrieval-Augmented Generation) yondashuvi qo'llaniladi. Ushbu maqolada biz RAG qanday ishlashini, Gorgona kompaniyasining Knowledge Engine tizimi qanday vazifalarni hal qilishini va korporativ bilimlar bazasini yaratishda nimalarga e'tibor berish muhimligini: hujjatlarni yuklash va kirish huquqlarini sozlashdan tortib, qidiruv va javoblarning sifatini baholashgacha ko'rib chiqamiz.
Til modellari matn bilan ishlash, ma'lumotlarni tahlil qilish va savollarga javob berishni biladi. Ammo har qanday modelning cheklovi bor: u ayni paytda aniq bir kompaniya ichida nima bo'layotganini, rahbariyat qanday qarorlar qabul qilganini, dolzarb hujjatlar qayerda saqlanayotganini va ichki jarayonlarda qanday qoidalar amal qilayotganini bilmaydi.
SI dan mijoz savoliga javob tayyorlash, xodim uchun ko'rsatma topish yoki ichki reglamentni tushuntirishni so'rash mumkin. Ammo agar kerakli ma'lumot model kontekstida bo'lmasa, u kompaniya hujjatlariga asoslanib ishonchli javob bera olmaydi.
Nazariy jihatdan modelni korporativ ma'lumotlar asosida qayta o'qitish (fine-tuning) yoki unga hujjatlar katta massivini to'liq uzatish mumkin. Amaliyotda har ikkala yondashuvning cheklovlari mavjud: qayta o'qitish qo'shimcha resurslarni talab qiladi va o'zgaruvchan ma'lumotlar bilan ishlash uchun har doim ham mos kelavermaydi, so'rovda hujjatlar to'plamining to'liq uzatilishi esa qimmat va samarasiz bo'lishi mumkin.
Shuning uchun ichki bilimlar bilan ishlash uchun boshqa yondashuvdan foydalaniladi — RAG (Retrieval-Augmented Generation). Gorgona platformasida korporativ bilimlar bilan ishlash va ularga kirishni boshqarish uchun alohida Knowledge Engine moduli ko'zda tutilgan.
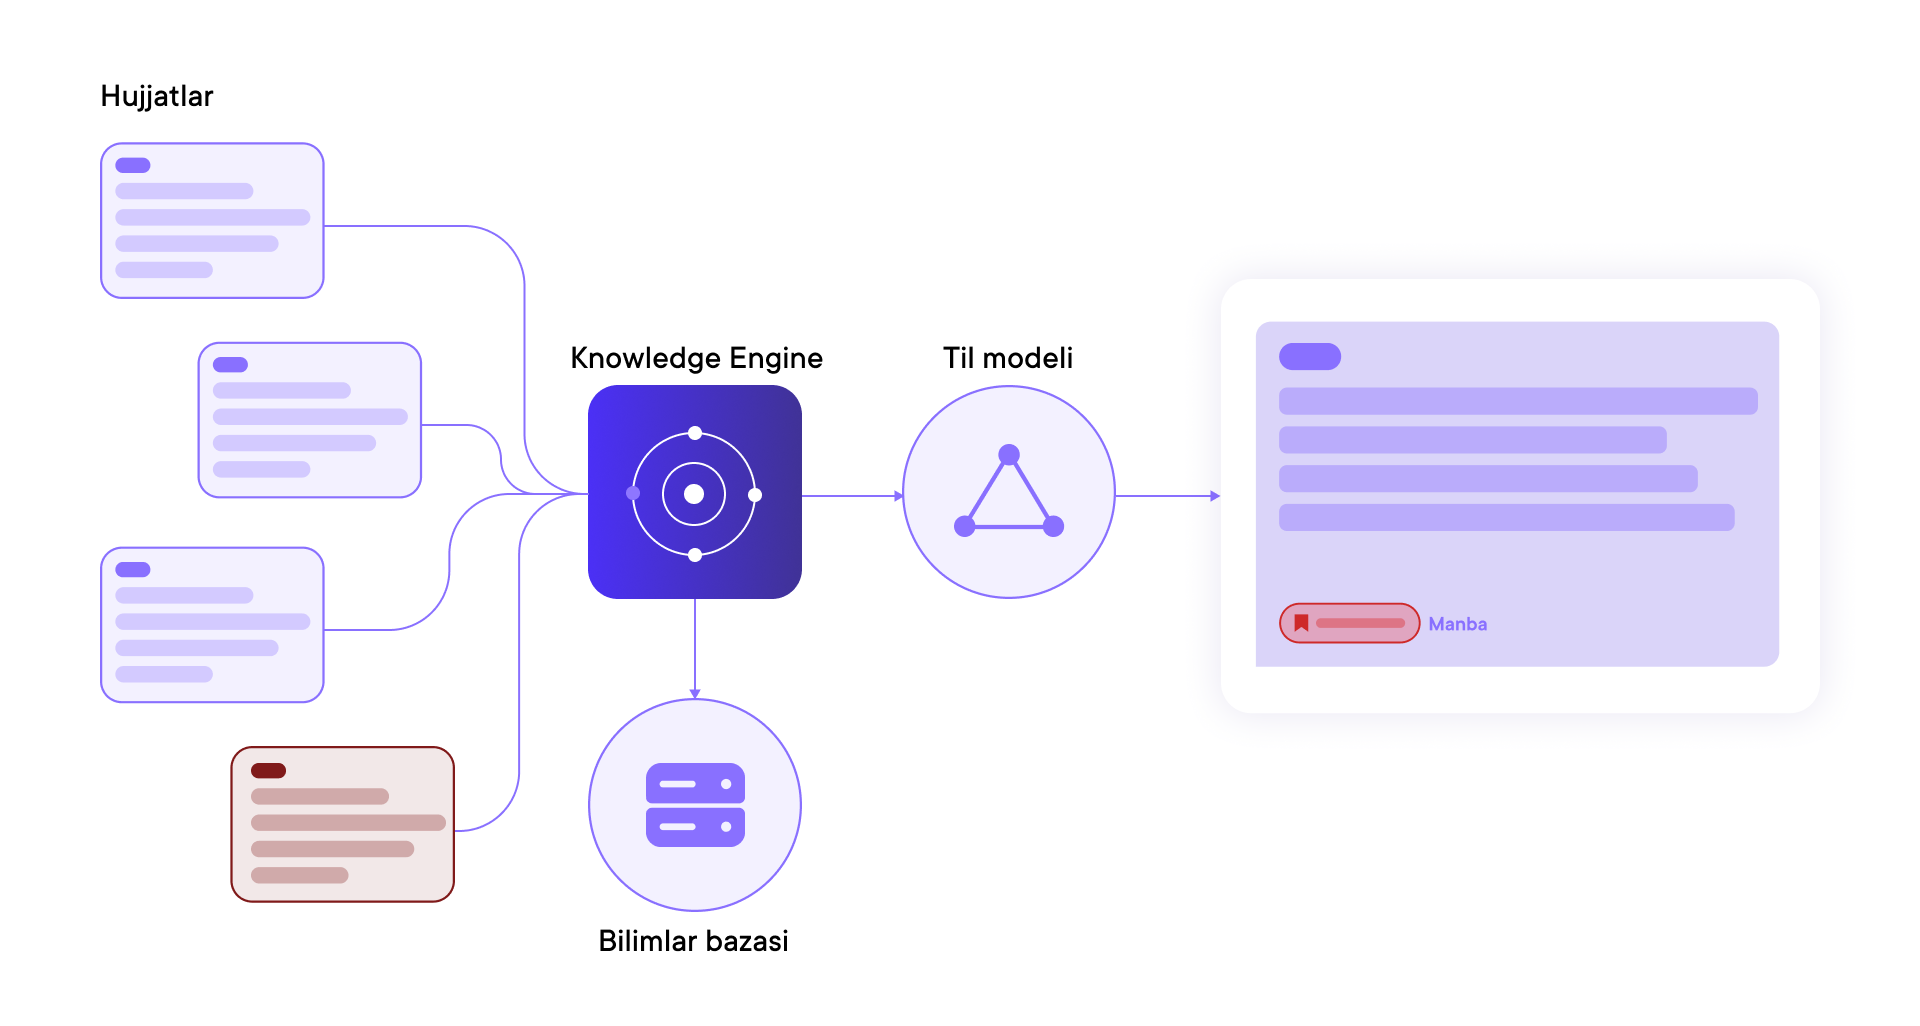
Knowledge Engine SIga korporativ hujjatlarga kirishni tashkil qilishga yordam beradi: ma'lumotlarni ma'no jihatidan topish, modelga mos fragmentlarni uzatish va savol berayotgan foydalanuvchining huquqlarini hisobga olish.
Modulni turli ssenariylarda ishlatish mumkin:
- Mijozlarni qo'llab-quvvatlash. Operatorlar va chat-botlar qaytarish, yetkazib berish, kafolatlar va boshqa jarayonlar bo'yicha reglamentlarga asoslanib javob oladilar.
- Ichki helpdesk. Xodimlar HR, axborot xavfsizligi va IT siyosatlaridan javoblarni topishlari mumkin.
- Yuridik va me'yoriy hujjatlar. Qidiruv shartnomalar, ichki reglamentlar va me'yoriy materiallar bilan ishlashga yordam beradi.
- Tashqi agent uchun bilimlar bazasi. Knowledge Engine buyurtmachi allaqachon mavjud bo'lgan SI-agentiga korporativ bilimlarga kirish huquqini taqdim etadi.
2. RAG nima va u qanday ishlaydi
RAG — bu shunday yondashuvki, unda javob shakllantirilishidan oldin tizim bilimlar bazasidan foydalanuvchi so'roviga mos (relevent) ma'lumotlarni topadi va uni til modeliga qo'shimcha kontekst sifatida uzatadi.
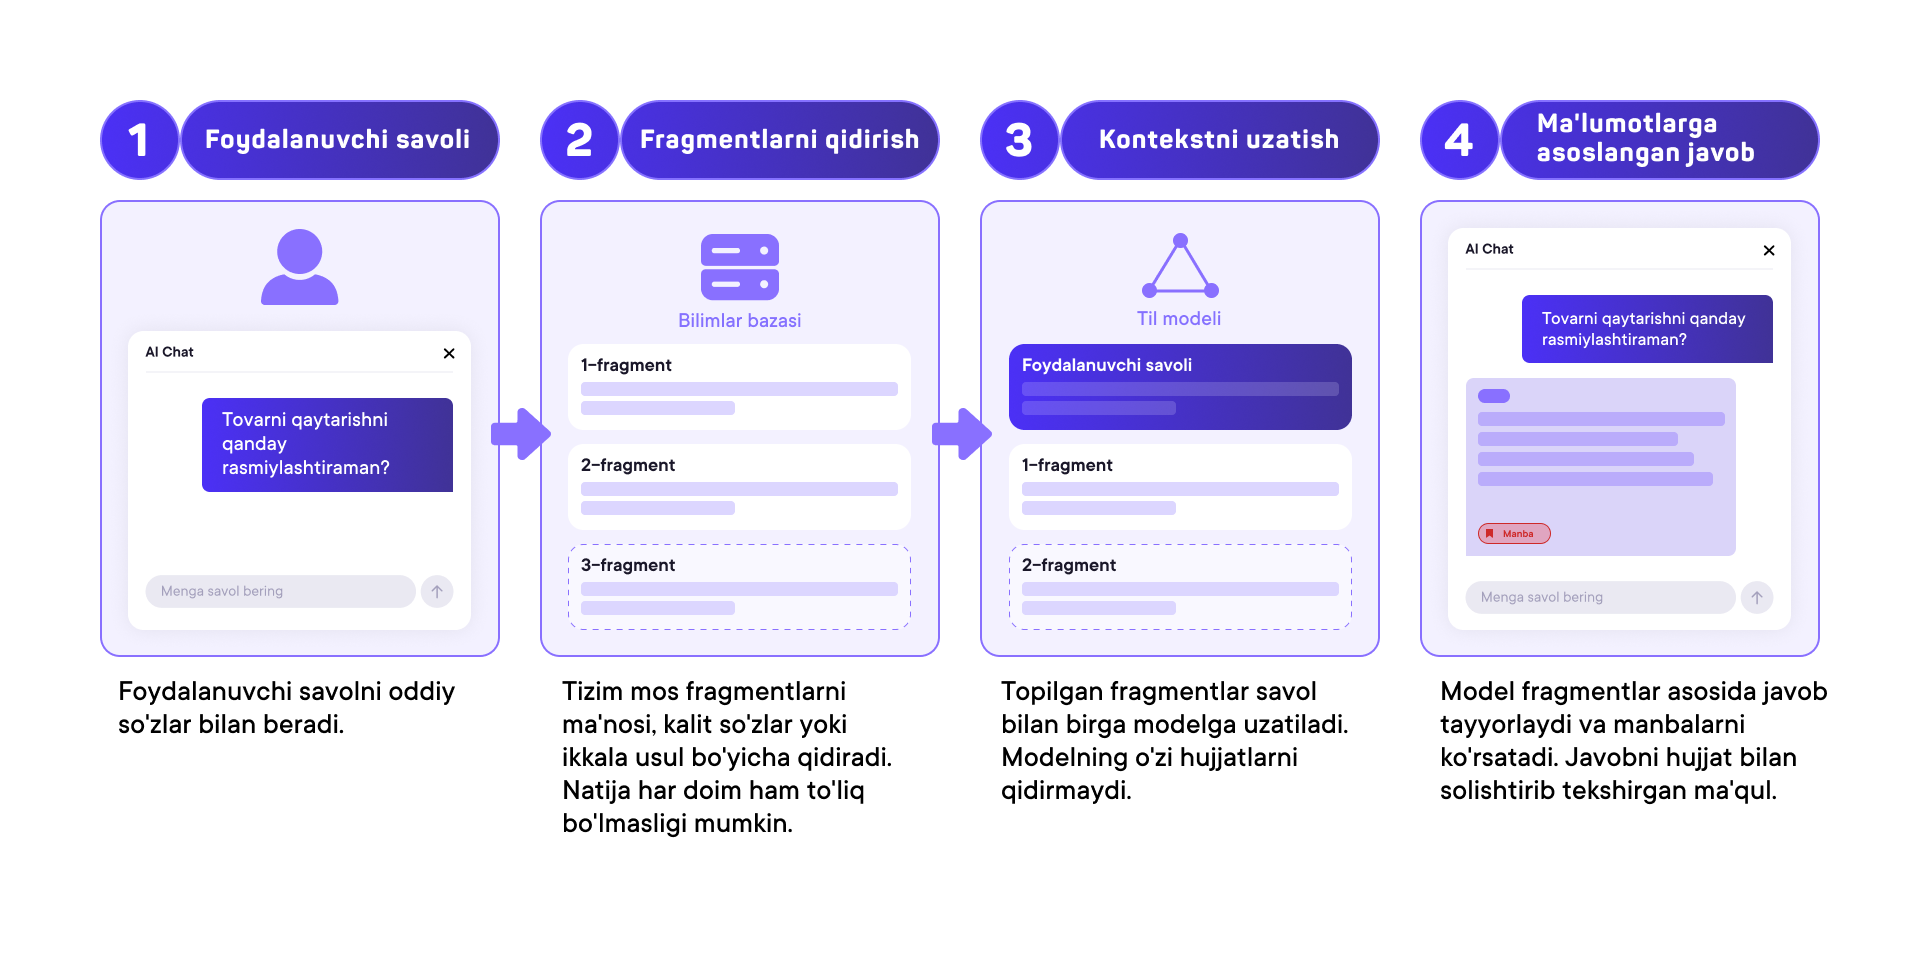
Tasavvur qiling, xodim so'rayapti: "Tovarni qanday qaytarish mumkin?"
Kompaniya hujjatlarida kerakli jarayon boshqacha ta'riflangan bo'lishi mumkin: masalan, "Mahsulotni qaytarish bo'yicha murojaatlarni ko'rib chiqish tartibi". So'zlarning aniq mosligi bo'yicha oddiy qidiruv mos fragmentni topa olmasligi mumkin. Semantik qidiruv esa so'rovni hujjat bilan ma'no jihatidan taqqoslash imkonini beradi.
Bu ishlashi uchun hujjatlar oldindan qayta ishlanadi:
- Hujjatlarni tayyorlash. Matn yuklangan fayllardan yoki ulangan manbalardan ajratib olinadi.
- Fragmentlarga bo'lish. Katta hujjat kichik qismlarga — chanklarga (chunks) bo'linadi. Bu butun hujjatni modelga to'liq uzatmasdan, alohida ma'naviy fragmentlarni qidirish imkonini beradi.
- Indekslash. Tizim fragmentlarni qidiruvga tayyorlaydi va buning uchun zarur bo'lgan ma'lumotlarni saqlaydi.
- So'rov bo'yicha qidiruv. Foydalanuvchi savol berganda, tizim eng mos fragmentlarni qidiradi.
- Javobni shakllantirish. Topilgan fragmentlar asl savol bilan birga til modeliga uzatiladi. Model javob tayyorlash uchun ushbu kontekstdan foydalanadi.
Masalan, qaytarish qoidalarini mustaqil eslash o'rniga, SI ichki ko'rsatmaning mos fragmentlarini oladi va ular asosida javob shakllantiradi.
Knowledge Engine'da qidiruvning uchta rejimi mavjud: ma'no bo'yicha, kalit so'zlar bo'yicha va gibrid. Standart holatda ma'no jihatidan taqqoslashni kalit so'zlar bo'yicha qidiruv bilan birlashtiruvchi gibrid qidiruv ishlatiladi. Qo'shimcha ravishda natijalarni qayta saralashni (reranking) yoqish mumkin: bu mos fragmentlarni tanlash aniqligini oshirishga yordam beradi, garchi javob biroz sekinroq shakllanishi mumkin bo'lsa ham.
RAG javob har doim ham to'g'ri bo'lishini kafolatlamaydi. Natija dastlabki hujjatlarning sifati, qidiruv, qayta ishlash sozlamalari va modelning o'ziga bog'liq. Shuning uchun bilimlar bazasini nafaqat to'ldirish, balki muntazam ravishda tekshirib turish ham muhimdir.
3. Knowledge Engine nima qiladi
RAG — bu ma'lumotlarni qidirish va ulardan foydalanish yondashuvidir. Knowledge Engine — Gorgona moduli bo'lib, u ushbu jarayonni korporativ muhitda tashkil qilishga yordam beradi.
U nafaqat hujjatlarni qidirish vazifasini hal qiladi. Biznes uchun ma'lumotlar qayerdan kelayotganini, kim ularni ishlatishi mumkinligini, tizim kerakli ma'lumotlarni qanchalik yaxshi topayotganini va bilimlar bazasini dolzarb holatda qanday qo'llab-quvvatlashni tushunish muhimdir.
Knowledge Engine'da bilimlar bazalari bilan ishlash, hujjatlarni qayta ishlash, ularning mazmuni bo'yicha qidirish va kirish huquqlarini chegaralash uchun vositalar ko'zda tutilgan. Korporativ bilimlar bilan ishlashning kengroq doirasida sifat nazorati, so'rovlarni kuzatish va bazani qo'llab-quvvatlash jarayonlari ham muhimdir.
Knowledge Engine'ni Gorgona'ning boshqa modullari bilan birgalikda ishlatish yoki buyurtmachi vazifasiga qarab alohida ssenariyga ulash mumkin. Masalan, kompaniyada allaqachon korporativ ma'lumotlarga kirish yetishmayotgan o'zining SI-agenti bo'lishi mumkin.
Tashqi agentni ikki usulda ulash mumkin: LLM Box orqali — kirish kaliti bilan OpenAI-ga mos API orqali yoki Gorgona agentini chaqirish imkonini beruvchi Agent API orqali. Har ikkala holatda ham bilimlar bazasi bo'yicha qidiruv va huquqlarni tekshirish platforma tomonida amalga oshiriladi: tashqi agentga bu mexanizmlarni mustaqil ravishda amalga oshirishning hojati yo'q.
4. Hujjatlar bilimlar bazasiga qanday tushadi
Korporativ ma'lumotlar kamdan-kam hollarda bitta joyda saqlanadi. Hujjatlar tarmoq papkalarida, bilimlarni boshqarish tizimlarida va boshqa ichki xizmatlarda bo'lishi mumkin. Shuning uchun Knowledge Engine'ni joriy etishdagi amaliy savollardan biri — kompaniya allaqachon foydalanayotgan manbalardan ma'lumotlar kelishini qanday tashkil qilishdir.
Bilimlar bazasiga hujjatlarni qo'shishning ikki usuli mavjud:
- Interfeys orqali qo'lda yuklash — fayllar yoki matn ko'rinishida.
- Konnektorlar yordamida korporativ tizimlarni ulash. Hozirda Confluence va Jira uchun tayyor konnektorlar mavjud. Boshqa manbalarni ulash rejalashtirilgan.
Knowledge Engine PDF, DOCX, HTML va Markdown fayllarini, shuningdek foydalanuvchi qo'lda kiritgan matnni qo'llab-quvvatlaydi. Yuklanadigan faylning maksimal hajmi 50 MB.
Korporativ tizimlardagi ma'lumotlar konnektorlarni sinxronlashtirish orqali yangilanadi. Agar hujjat qo'lda qo'shilgan bo'lsa, uni yangilash uchun qayta yuklash kerak bo'ladi.
Bilimlar bazasi tuzilishi "bilimlar bazasi → papkalar" sxemasi bo'yicha tashkil etilgan. Hujjatlarni kompaniya vazifalariga mos ravishda papkalarga taqsimlash mumkin: masalan, bo'linmalar, hujjat turlari yoki ish jarayonlari bo'yicha. Papkalar shuningdek kirish huquqlarini sozlash uchun ham ishlatiladi.
Yuklangandan so'ng hujjatlar qayta ishlashdan o'tadi: tizim matnni ajratib oladi, uni fragmentlarga bo'ladi va qidiruvga tayyorlaydi. Ichki OCR (optik belgilarni tanib olish) skanlarni to'g'ridan-to'g'ri yuklash imkonini beradi: qayta ishlash jarayonida tizim matn, jadvallar va formulalarni taniydi. Shu bilan birga, qog'oz hujjatlarni fizik skanerlash buyurtmachi tomonida qoladi.
5. SI kerakli ma'lumotlarni qanday topadi
Hujjatlarni tayyorlagandan so'ng, foydalanuvchi chatda savol berishi yoki Knowledge Engine'dan foydalanadigan agentga murojaat qilishi mumkin.
Model dastlabki so'rovni va o'ziga mavjud bo'lgan vositalar haqidagi ma'lumotni oladi. Agar unga qo'shimcha ma'lumotlar kerak bo'lsa va sozlangan integratsiya vositalarni chaqirishni qo'llab-quvvatlasa, model bilimlar bazasiga murojaat qiladi.
Knowledge Engine qidiruvni amalga oshiradi va dastlabki hujjatlar haqidagi ma'lumotlar bilan birga eng mos keladigan bir nechta fragmentlarni qaytaradi. Fragmentlar soni bilimlar bazasi sozlamalarida belgilanadi. Agar kontekst yetarli bo'lmasa, model belgilangan cheklovlar doirasida bazaga bir nechta so'rov yuborishi mumkin.
Model olingan ma'lumotlardan javob berish uchun foydalanadi. Shunday qilib, u barcha korporativ hujjatlarni to'liq olmaydi, balki tizim aniq so'rovga mos deb hisoblagan fragmentlarga murojaat qiladi.
Bunday ssenariy ishlatilayotgan modelning imkoniyatlari va sozlangan integratsiyaga bog'liq: har bir model vositalarni chaqirishni bir xil usulda qo'llab-quvvatlamaydi.
6. Kirish nazorati: aniq bir xodim qanday ma'lumotlardan foydalana oladi
Korporativ foydalanish uchun shunchaki SIga barcha hujjatlarga kirish huquqini berish yetarli emas. Turli xodimlar turli vakolatlarga ega va tizim ma'lumotlarni qidirishda buni hisobga olishi kerak.
Tasavvur qiling, kompaniyada bosh direktor, buxgalteriya va texnik yordam xizmati mavjud. Rahbarga korporativ ma'lumotlarga keng kirish huquqi kerak bo'lishi mumkin, yordam mutaxassisiga esa faqat o'z ishi bilan bog'liq ko'rsatmalar va hujjatlar kerak bo'ladi.
Agar barcha hujjatlar huquqlarni chegaralamasdan mavjud bo'lsa, xodim o'zi ko'rmasligi kerak bo'lgan ma'lumotlarni olish xavfi paydo bo'ladi.
Knowledge Engine'da bilimlar bazasi elementlariga kirish huquqi jamoalar bo'yicha chegaralanadi. Huquqlar papkalar uchun sozlanadi, shuning uchun hujjatlarga qaysi jamoalar uchun mo'ljallanganligini hisobga olgan holda kirishni tashkil qilish mumkin.
Cheklovlar qidiruv bosqichida hisobga olinishi muhimdir. Tizim ma'lumotlarni faqat foydalanuvchining kirish huquqi bo'lgan bilimlar sohasida qidirishi kerak, avval har qanday fragmentlarni ajratib olib, keyin taqiqlangan natijalarni yashirishga urinmasligi lozim.
Bu xodimga mavjud bo'lmagan ma'lumotlar til modeliga uzatiladigan kontekstga tushib qolmasligi uchun zarurdir.
Shunday qilib, Knowledge Engine aniq jamoalar uchun ruxsatnomalarni hisobga olgan holda korporativ ma'lumotlarga boshqariladigan kirishni tashkil qilishga yordam beradi.
7. Nafaqat qidiruv: korporativ bilimlarni nazorat qilish va qo'llab-quvvatlash
Bilimlar bazasi hujjatlarni yuklash bosqichida tugamaydi. Ma'lumotlar o'zgaradi, yangi ko'rsatmalar paydo bo'ladi, eski hujjatlar dolzarbligini yo'qotadi, qidiruv natijalari esa mos kelmasligi mumkin. Shuning uchun kim bilimlar bazasi holatini kuzatib borishi va uni ishchi holatda qo'llab-quvvatlashini aniqlash muhimdir.
Buning uchun biz buyurtmachiga Data Steward (Ma'lumotlar kuryatori) rolini ajratishni tavsiya qilamiz. Ushbu xodim bazaning dolzarbligiga javob beradi: hujjatlarni yangilaydi, kirish huquqlari va qidiruv sifatini kuzatib boradi. Bu buyurtmachi tomonidagi tashkiliy rol bo'lib, Knowledge Engine interfeysida tayinlanishi kerak bo'lgan alohida rol emas.
Mahsulotning o'zida hujjatlarni boshqarish vositalari ko'zda tutilgan:
- har bir hujjat uchun qayta ishlash holatlari;
- hujjatlarni almashtirish va o'chirish imkoniyati;
- qayta ishlash sozlamalari o'zgarganda qayta indekslash. Qayta indekslash vaqtida qidiruv ishlashda davom etadi.
Ushbu vositalar hujjatlar va qidiruv talablari o'zgargan sari bilimlar bazasini qo'llab-quvvatlashga yordam beradi.
8. Qidiruv va javoblarning sifatini qanday baholash mumkin
Hujjatlar to'g'ri yuklangan bo'lsa ham, bu tizim har bir holatda kerakli fragmentlarni topadi degani emas.
Sifatga bir nechta omillar ta'sir qiladi: hujjat qanday qilib fragmentlarga bo'linganligi, dastlabki matn qanchalik yaxshi tuzilganligi va tanlangan qidiruv usuli ma'lumotlarning aniq turi uchun mos kelishi yoki kelmasligi.
Masalan, uzun yuridik hujjatlarda murakkab o'zaro havolalar va bo'limlar o'rtasidagi bog'liqliklar bo'lishi mumkin. Agar bunday hujjatni kichik mustaqil fragmentlarga bo'lsak, kontekstning bir qismi yo'qolishi mumkin. Turli xil hujjat turlari uchun fragmentlarga bo'lish usuli va o'lchamini tanlash mumkin; bu sozlamalarni o'zgartirish qidiruvni to'xtatmaydi.
Sifatni baholash yondashuvlaridan biri bu Golden Dataset (Oltin ma'lumotlar to'plami) bo'lib, biz joriy etish jarayonida shu usul bilan ishlaymiz. Buyurtmachi bilan birgalikda nazorat savollari va etalon javoblar to'plami tayyorlanadi.
Bunday to'plam bilan ishlash quyidagicha ko'rinishga ega bo'lishi mumkin:
- Buyurtmachi bilan birgalikda uning jarayonlari uchun haqiqatan ham muhim bo'lgan savollar ro'yxati shakllantiriladi.
- Har bir savol uchun etalon javob yoki baholash mezonlari tayyorlanadi.
- Bilimlar bazasining joriy konfiguratsiyasida sinovdan o'tkazish boshlanadi.
- Tizim javoblari baholovchi model yordamida etalonlar bilan solishtiriladi.
- Natijalar tahlil qilinadi va hujjatlarni qayta ishlash, qidiruv yoki boshqa parametrlar sozlamalari o'zgartiriladi.
- Sifat yaxshilangani yoki yo'qligini tushunish uchun tekshiruv takrorlanadi.
Bunday baholash konfiguratsiyalarni solishtirish va muammoli joylarni topishga yordam beradi. Biroq, olingan metrika SI aniqligining universal ko'rsatkichi emas: uning qiymati tanlangan savollar, etalonlar va solishtirish usuliga bog'liq.
Qo'shimcha ravishda, qidiruv sifatini Search playground (test qidiruvi) da qo'lda tekshirish mumkin. Unda tizim qanday fragmentlarni topayotgani va ular qaysi hujjatlardan olinganligi ko'rinib turadi. Bu aniq so'rov nima uchun ma'lum natijalarni qaytarayotganini tushunishga va qidiruv kerakli materiallar bilan qanchalik yaxshi ishlayotganini baholashga yordam beradi.
Avtomatik testlar va qo'lda tekshiruv foydalanuvchilar bilan birgalikda real ish ssenariylarida tekshiruvni bekor qilmaydi.
9. Kuzatiluvchanlik: javob qayerdan kelib chiqqanini qanday tushunish mumkin
SI korporativ bilimlardan foydalanganda, nafaqat yakuniy javobni, balki tizim shu javobga qanday kelgan yo'lni ham tushunish muhimdir.
Administrator uchun Gorgona platformasi treyslarida (traces) foydalanuvchi qanday savol berganini, model bilimlar bazasiga qanday murojaat qilganini va qanday fragmentlarni olganini ko'rish mumkin. Bu javob kutilmagan bo'lib chiqqan vaziyatda tushunishga va tizim uni tayyorlashda qanday ma'lumotlardan foydalanganini aniqlashga yordam beradi.
Foydalanuvchi ham chatda javob manbalarini ko'rishi mumkin: javob ostida ma'lumot olingan bilimlar bazasi va hujjat ko'rsatiladi.
Treyslar Gorgona platformasining umumiy funksionalligiga tegishli; kuzatiluvchanlik haqida batafsil ma'lumot alohida materialda keltiriladi.
10. Knowledge Engine'ni qanday joriy etish kerak
Korporativ bilimlar bazasini joriy etish barcha fayllarni ketma-ket yuklashdan emas, balki SIga qanday ma'lumotlar kerakligi va kim ularga kirish huquqiga ega bo'lishi kerakligini tushunishdan boshlanadi.
1-qadam. Vazifalar va ma'lumotlar manbalarini aniqlash. SI qanday savollarga javob berishi kerakligini, kerakli ma'lumotlar qayerda saqlanishini va ular qanchalik tez-tez o'zgarishini tushunish kerak.
2-qadam. Bilimlar tuzilmasini tashkil qilish. Hujjatlar bilimlar bazalari va papkalarga taqsimlanadi — masalan, bo'linmalar, hujjat turlari yoki ish jarayonlari bo'yicha. Bu ma'lumotlar to'plamlarini ajratishga va ularga kirishni sozlashga yordam beradi.
3-qadam. Ma'lumotlarni olishni sozlash. Yuklash usuli tanlanadi: qo'lda yoki korporativ tizimlarga konnektorlar orqali. Mavjud tayyor konnektorlardan tashqari boshqa manbalar uchun amalga oshirilishini kutish yoki integratsiya variantini alohida kelishish talab qilinishi mumkin.
4-qadam. Hujjatlarni qidiruvga tayyorlash. Matnni qayta ishlash parametrlari, fragmentlarga bo'lish usuli va o'lchami, shuningdek qidiruv rejimi tanlanadi. Sozlamalar turli xil hujjat turlari uchun farq qilishi mumkin.
5-qadam. Kirishni sozlash. Qaysi jamoalar aniq bilimlar bazalari va papkalarga murojaat qilishi mumkinligi aniqlanadi.
6-qadam. Sifatni tekshirish. Nazorat savollari to'plami yaratiladi, qidiruv va javoblar sinovdan o'tkaziladi, xatolar tahlil qilinadi va konfiguratsiya tuzatiladi. Qo'lda tekshirish uchun Search playground'dan foydalanish mumkin.
7-qadam. Foydalanuvchilar bilan tekshiruv o'tkazish. Tizim real ish vazifalarini hal qilayotganiga, odatiy so'rovlarni to'g'ri qayta ishlayotganiga va ortiqcha ma'lumotlarni taqdim etmayotganiga ishonch hosil qilish kerak.
8-qadam. Qo'llab-quvvatlashni tashkil qilish. Hujjatlarni yangilash, huquqlarni va qidiruv sifatini nazorat qilish uchun kim javobgar ekanligi aniqlanadi. Buning uchun buyurtmachiga Data Steward ajratish tavsiya etiladi. Agar ma'lumotlar dastlabki tizimlarda o'zgarsa, konnektorlarni sinxronlashtirishni ham tashkil qilish kerak; qo'lda yuklangan hujjatlar qayta yuklash orqali yangilanadi.
Qog'oz arxivlar bilan ishlashda buyurtmachi avval hujjatlarni skanerlashi kerak. Shundan so'ng skanlarni to'g'ridan-to'g'ri Knowledge Engine'ga yuklash mumkin: ichki OCR qayta ishlash jarayonida matn, jadvallar va formulalarni taniydi.
11. RAG qayerda tugab, Knowledge Engine qayerda boshlanadi
Bu tushunchalarni aralashtirib yubormaslik muhimdir.
- RAG — mos ma'lumotlarni topish va javob shakllantirish uchun uni til modeliga uzatish imkonini beruvchi yondashuvdir.
- Knowledge Engine — korporativ bilimlar bilan ishlashni tashkil qiladigan va qidiruv jarayoniga kirishni boshqarish hamda bazani qo'llab-quvvatlash imkoniyatlarini qo'shadigan Gorgona modulidir.
Gorgona — SI bilan ishlash uchun turli xil vositalar mavjud bo'lgan platformadir. Knowledge Engine boshqa modullar bilan birgalikda ishlatilishi yoki buyurtmachi vazifasiga qarab aniq ssenariyga ulanishi mumkin.
Umumiy mahsulot logikasi doirasida boshqa modullar jarayonning o'z qismlari uchun javobgardir. LLM Box til modellarini ulash va ulardan foydalanishni boshqarish uchun mo'ljallangan, Guardrails esa model so'rovlari va javoblariga qoidalar qo'llash uchun xizmat qiladi. Knowledge Engine korporativ ma'lumotlar bilan ishlaydi va aniq ssenariyda qanday bilimlar mavjud bo'lishi mumkinligini aniqlaydi.
Bu vazifalar o'zaro bog'liq, ammo o'zaro almashtirilmaydi. Masalan, xodimning ichki bazadan ma'lumot olish huquqi va tashqi modelga qanday ma'lumotlar uzatilayotganini tekshirish — bu turli xil nazorat mexanizmlarini talab qiladigan turli masalalardir.
12. Biznes nima oladi
Kompaniya uchun Knowledge Engine — bu til modelining umumiy bilimlarida mavjud bo'lmagan ichki ma'lumotlar bilan SI ishini tashkil qilish usulidir.
Turli xil saqlash joylarida qo'lda ko'rsatmalarni qidirish yoki qidiruv infratuzilmasini mustaqil ravishda ishlab chiqish o'rniga, kompaniya SI korporativ hujjatlarning mos fragmentlarini oladigan jarayonni tuzishi mumkin.
Bunda nafaqat ma'lumotlarni olish tezligi, balki jarayonning boshqariluvchanligi ham muhimdir:
- xodimlar o'z jamoalariga ruxsat berilgan ma'lumotlarga kirish huquqini oladilar;
- SI javoblarni tayyorlashda ichki hujjatlardan foydalanishi mumkin;
- qidiruv sifatini nazorat savollarida va test qidiruvida qo'lda tekshirish mumkin;
- bilimlar bazasi bilan ishlashni qo'llab-quvvatlash va yaxshilash mumkin;
- administratorlar platforma treyslari yordamida modelning bilimlar bazasiga murojaatini tahlil qilishlari, foydalanuvchilar esa chatda javob manbalarini ko'rishlari mumkin.
Shu bilan birga, Knowledge Engine hujjatlarni dolzarb holatda saqlash, natijalarni tekshirish va kirish huquqlarini to'g'ri tashkil qilish zaruratini bekor qilmaydi. U korporativ bilimlar bilan ishlash uchun infratuzilma yaratadi, ammo natija sifati hali ham ma'lumotlar, sozlamalar va foydalanishning aniq ssenariysiga bog'liq.
Knowledge Engine'ning asosiy g'oyasi — SIga kompaniya bilimlariga boshqariladigan kirishni taqdim etishdir, shunda u nafaqat til modeli o'qitilgan ma'lumotlarga, balki ichki ma'lumotlarga asoslanib ish savollariga javob bera oladi.